Publications

学术成果

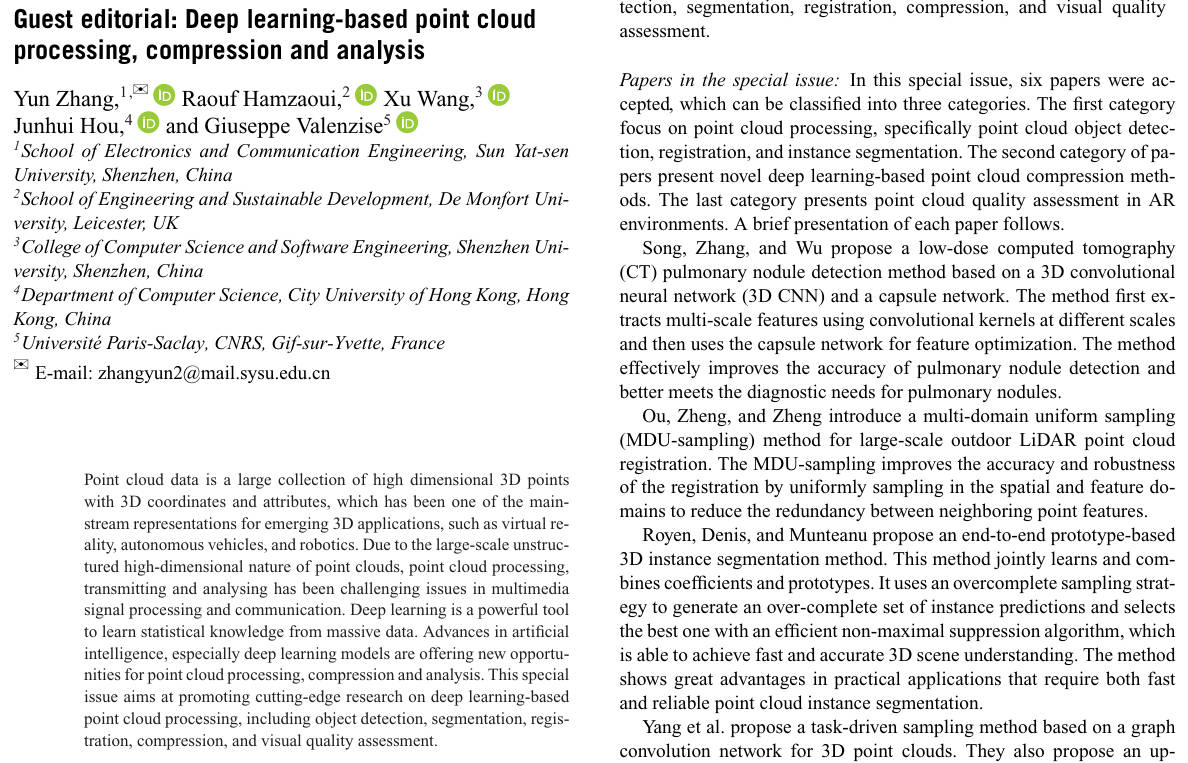
团队近三年的学术论文成果如下,更多论文可访问张云教授个人主页。

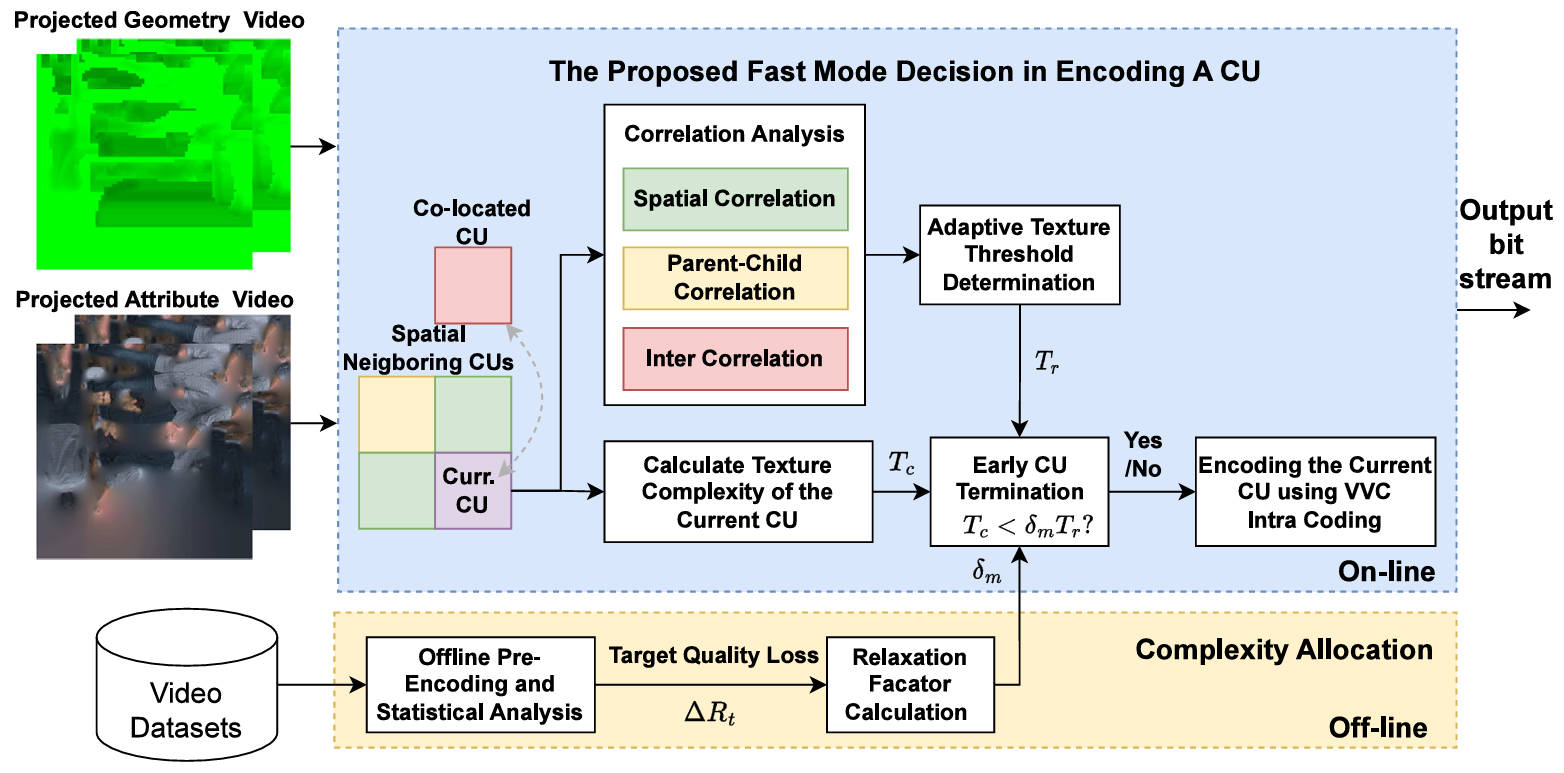
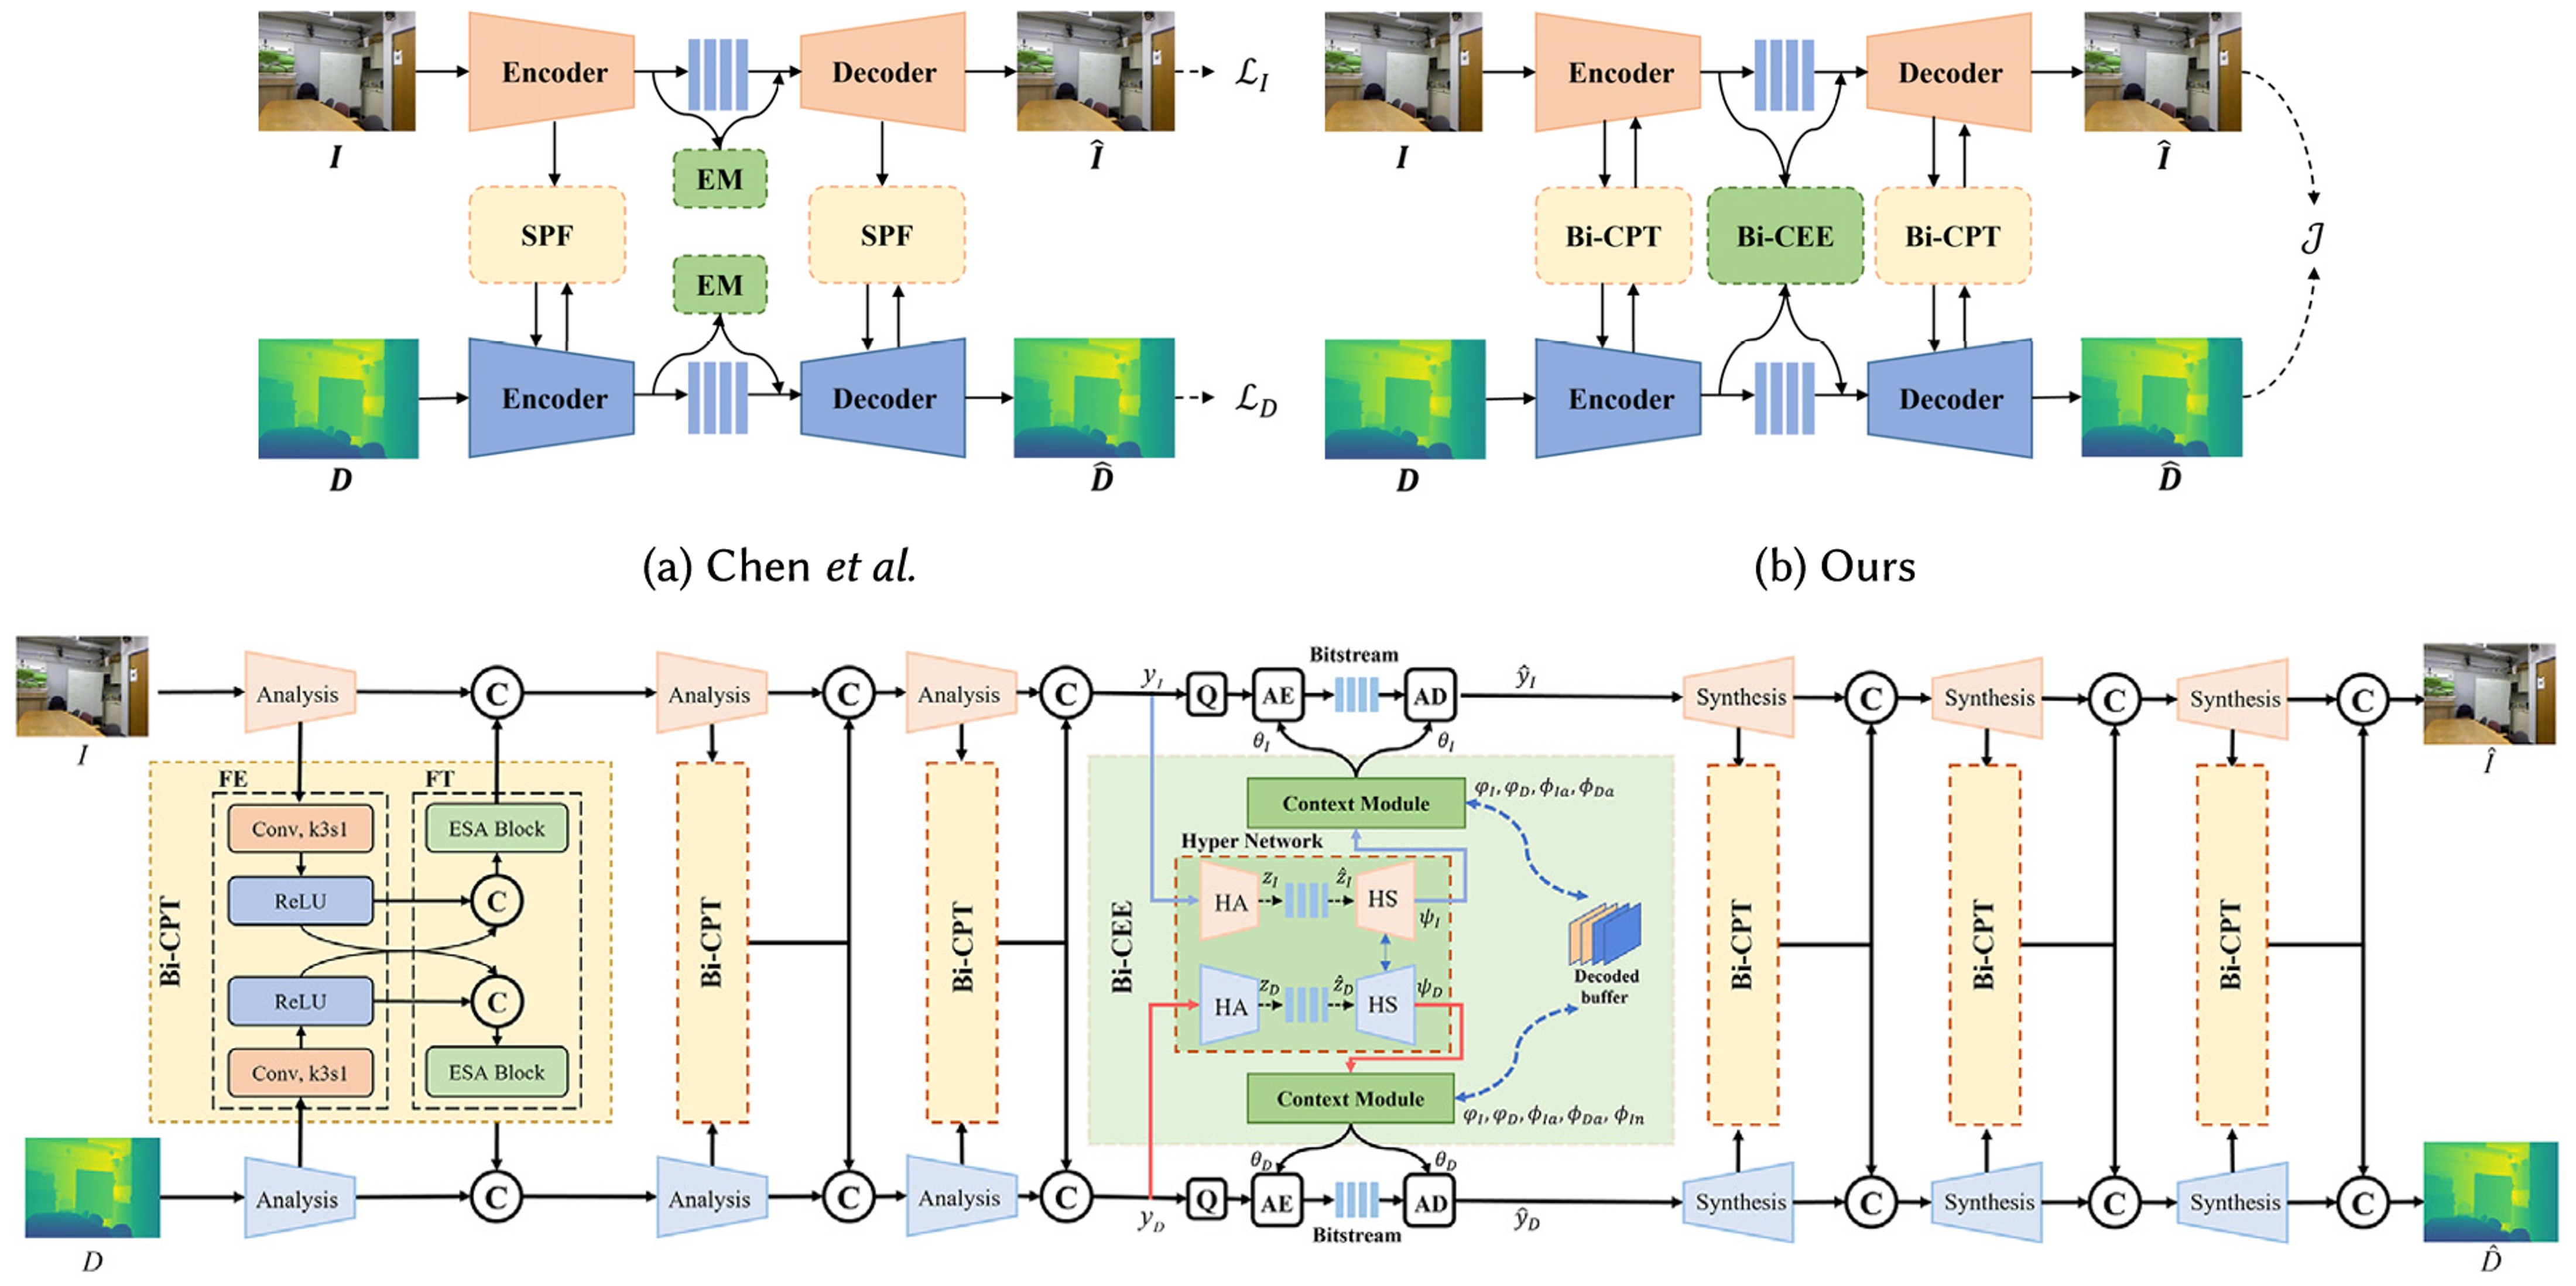
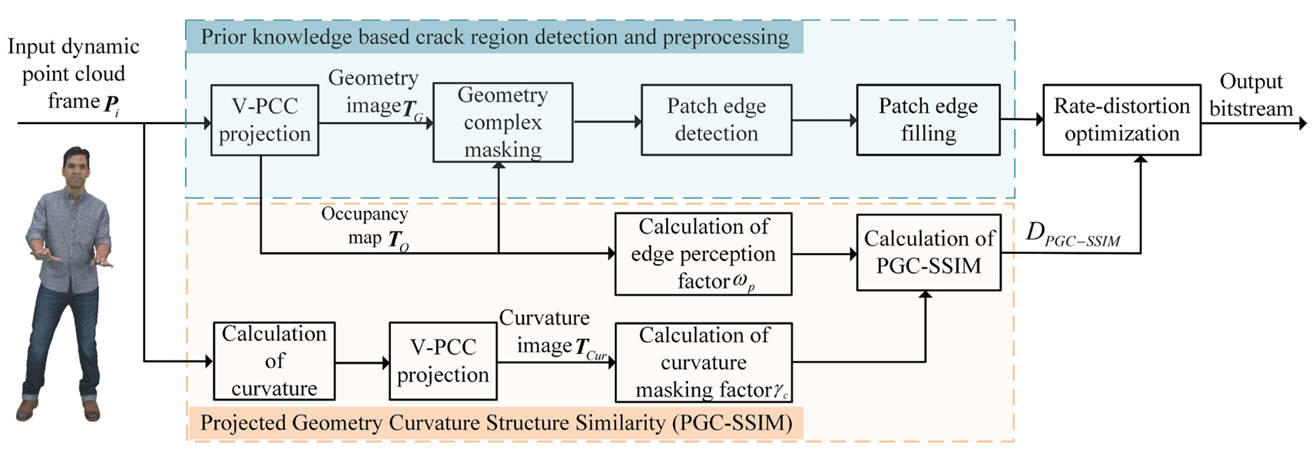
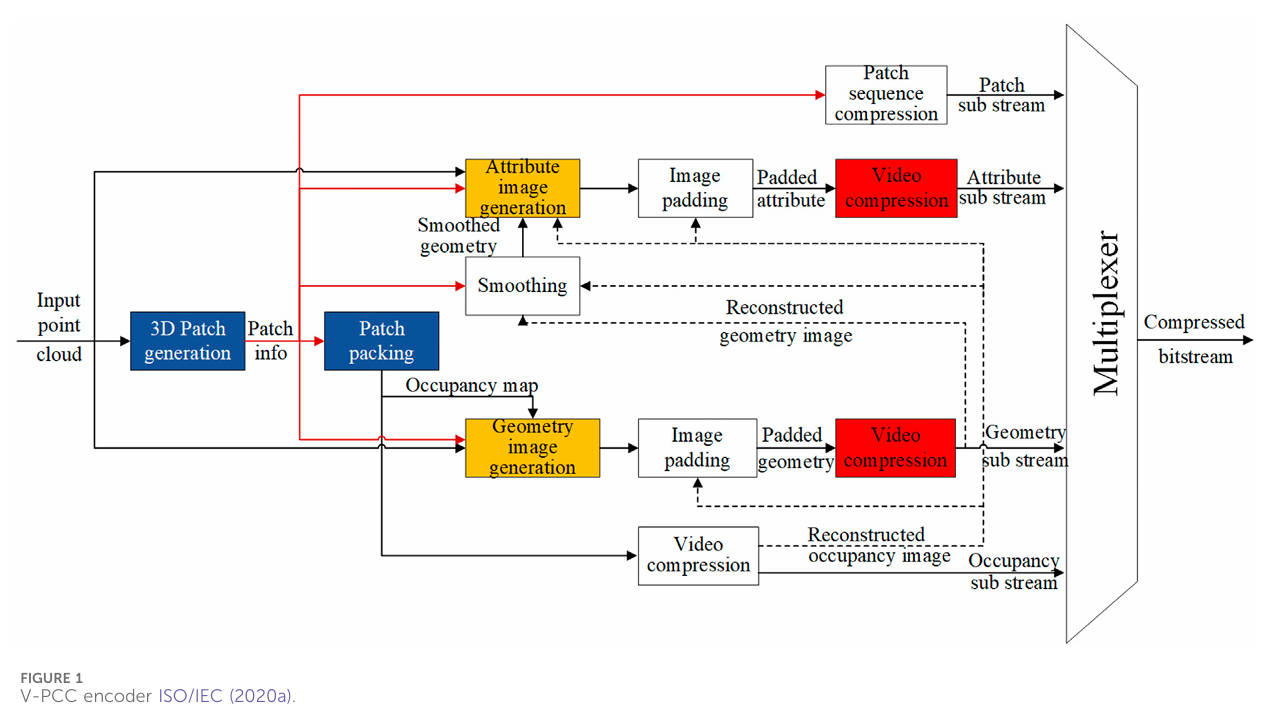
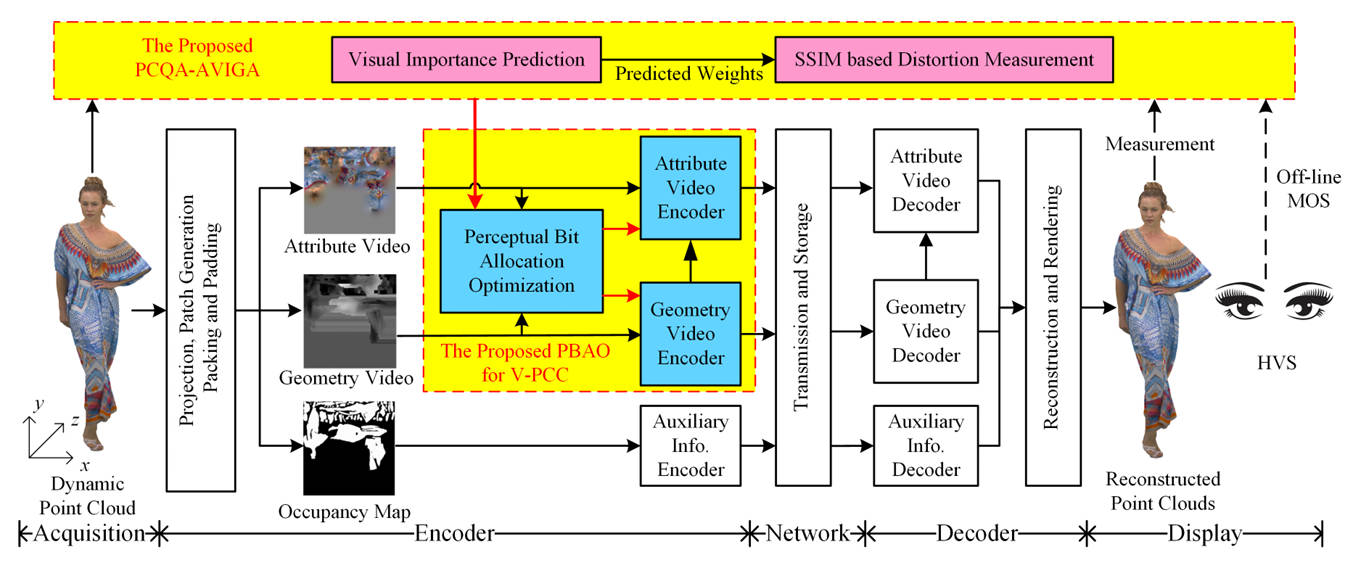
论文代表图:Perceptually Optimized Bit Allocation Between Attribute and Geometry for Video-Based Point Cloud Compression
Perceptually Optimized Bit Allocation Between Attribute and Geometry for Video-Based Point Cloud Compression

Yun Zhang, Lewen Fan, Mao Cui, Xiaoxia Huang, Sam Kwong. IEEE Transactions on Circuits and Systems for Video Technology, 2026.

简介:针对 V-PCC 中几何与属性信息的视觉重要性随点云内容变化、固定分配策略难以兼顾感知质量的问题,提出基于几何—属性自适应视觉重要性的点云质量评价模型 PCQA-AVIGA,并建立二维/三维感知失真与码率模型。进一步设计两种 PBAO 感知比特分配方案,在总码率约束下自适应优化几何与属性量化参数,平均降低 6.44% BDBR。
papercodeprojectdigest
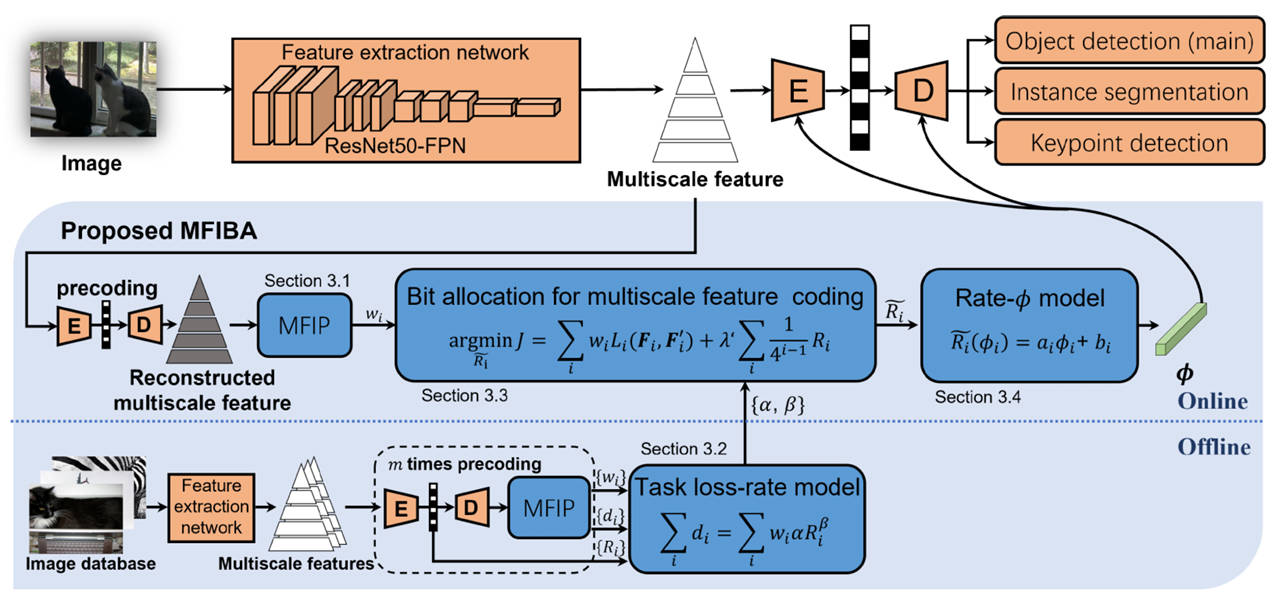
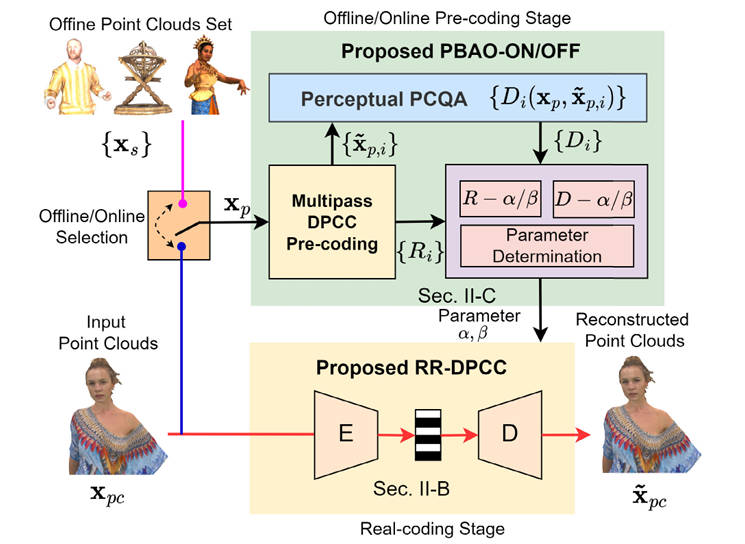
论文代表图:Rate-Reconfigurable Deep Point Cloud Compression With Perceptual Bit Allocation Optimization
Rate-Reconfigurable Deep Point Cloud Compression With Perceptual Bit Allocation Optimization

Yun Zhang, Lewen Fan, Zixi Guo, Xu Wang, Xiaoxia Huang, Sam Kwong. IEEE Transactions on Image Processing, vol. 35, pp. 3451-3465, 2026.

简介:针对不同目标码率需要分别训练模型的问题,提出可重配置的 RR-DPCC,并设计在线/离线感知比特分配策略。该方法用单一模型实现灵活码率控制,同时协调点云几何与属性的编码开销。

papercodeprojectdigest
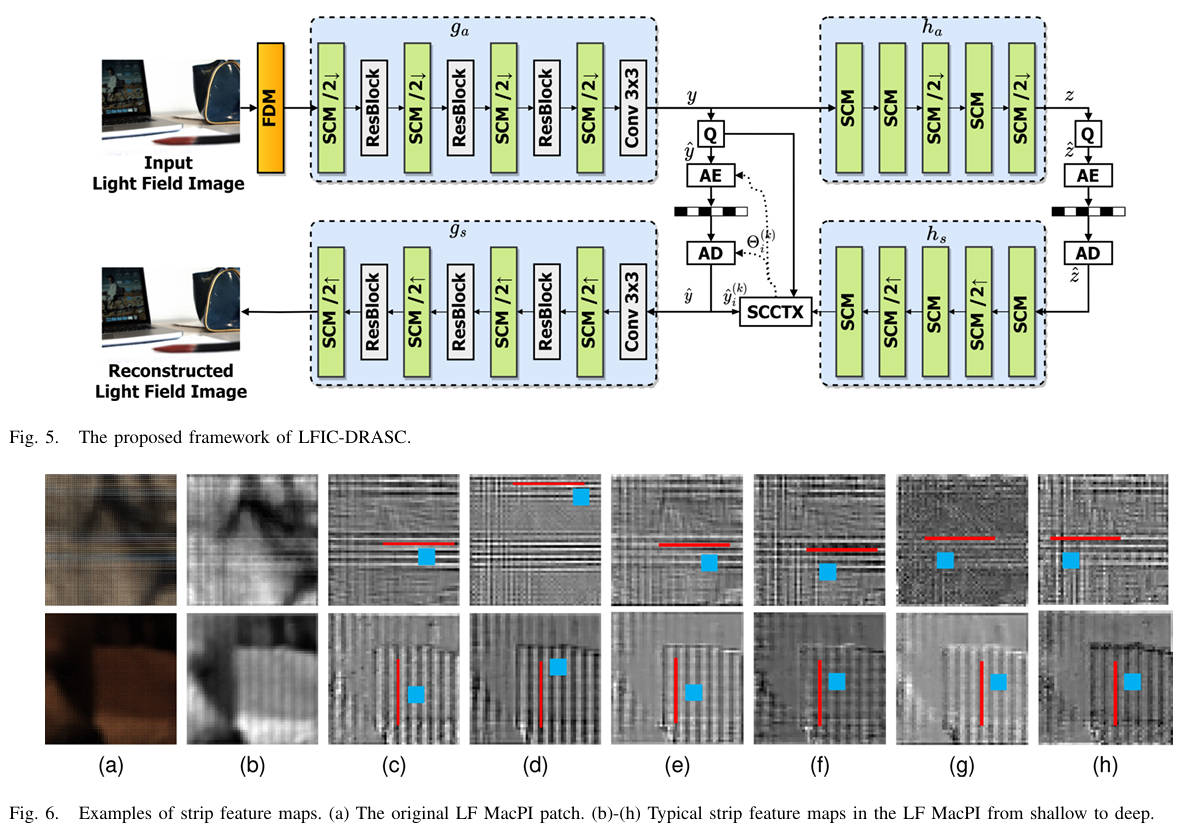
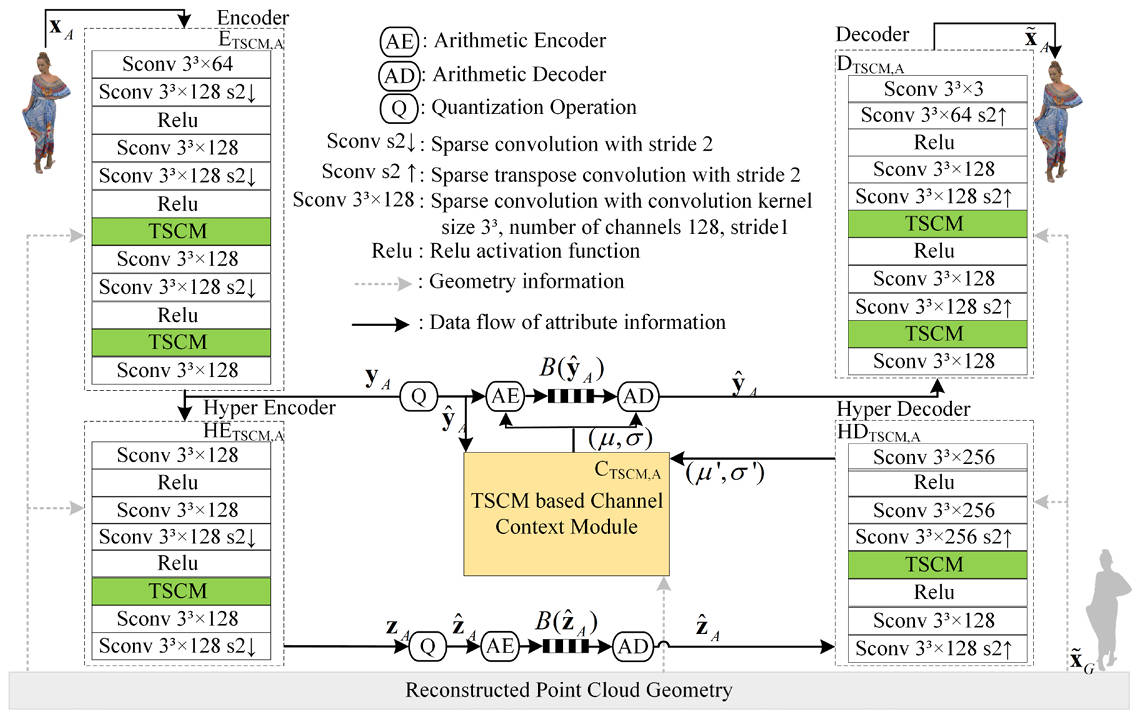
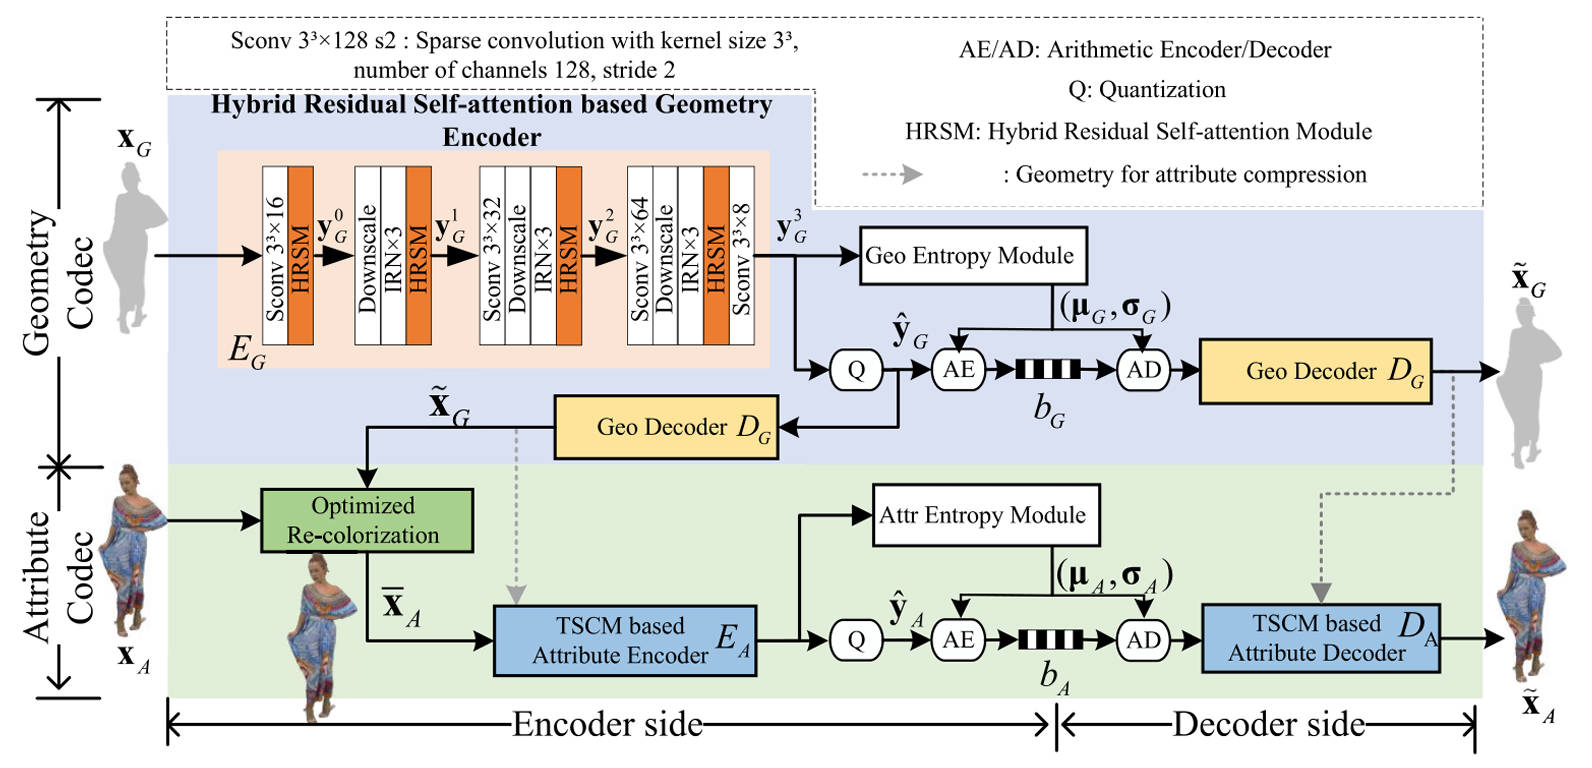
论文代表图:Deep-JGAC: End-to-End Deep Joint Geometry and Attribute Compression for Dense Colored Point Clouds
Deep-JGAC: End-to-End Deep Joint Geometry and Attribute Compression for Dense Colored Point Clouds

Yun Zhang, Zhiwei Guo, Zixi Guo, Linwei Zhu, C.-C. Jay Kuo. IEEE Transactions on Circuits and Systems for Video Technology, 2026.

简介:面向稠密彩色点云,提出端到端几何与属性联合压缩框架 Deep-JGAC。方法通过残差自注意力几何编码、重着色与联合熵建模,提高两类信息的协同表示和编码效率。

papercodeprojectdigest
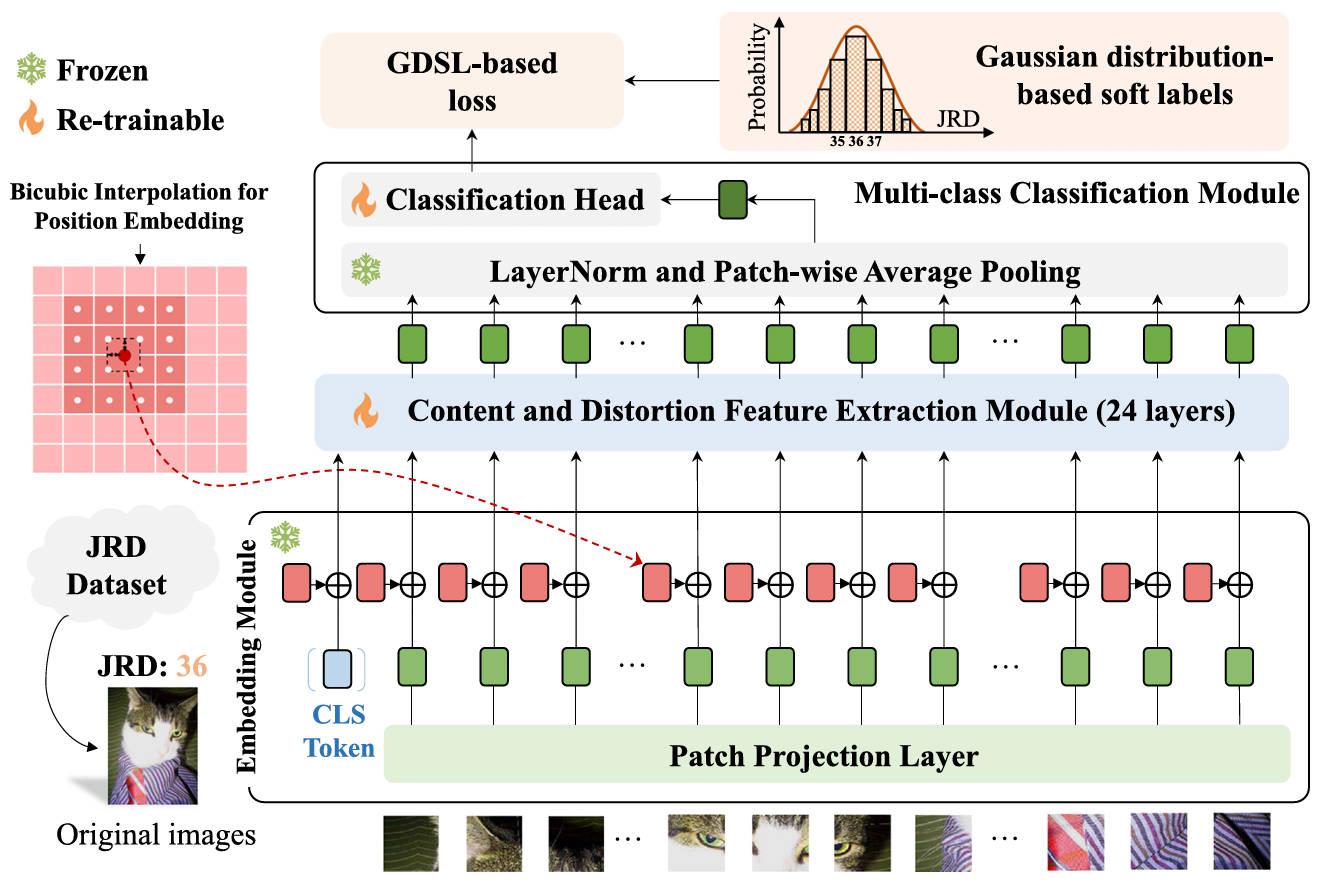
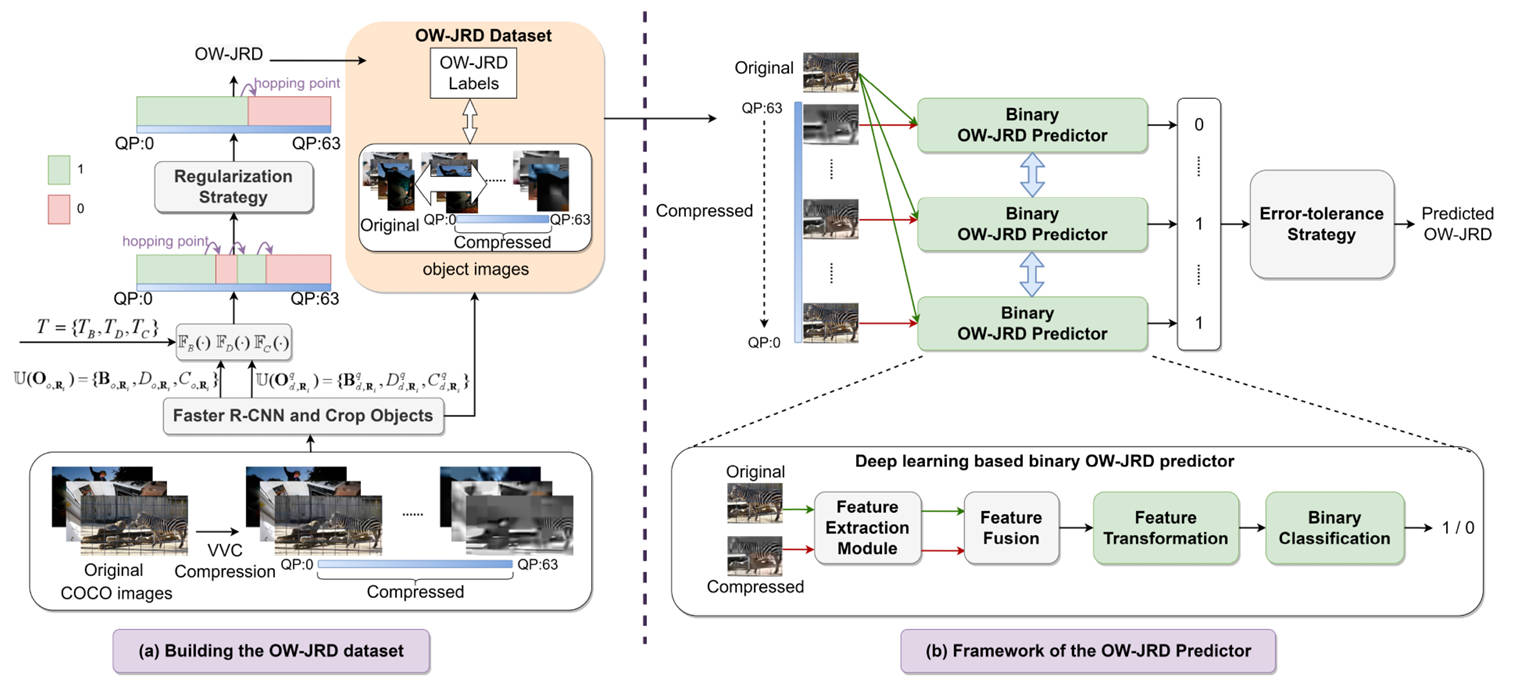
论文代表图:DT-JRD: Deep Transformer based Just Recognizable Difference Prediction Model for Video Coding for Machines
DT-JRD: Deep Transformer based Just Recognizable Difference Prediction Model for Video Coding for Machines

Junqi Liu, Yun Zhang, Xiaoqi Wang, Long Xu, Sam Kwong. IEEE Transactions on Multimedia, vol. 28, pp. 114-127, 2026.

简介:将机器视觉能够辨认的最小差异定义为 JRD,并把预测过程建模为多类别分类任务。Transformer 模型联合提取内容与失真特征,使编码器在维持机器分析精度的同时减少不必要的码率。

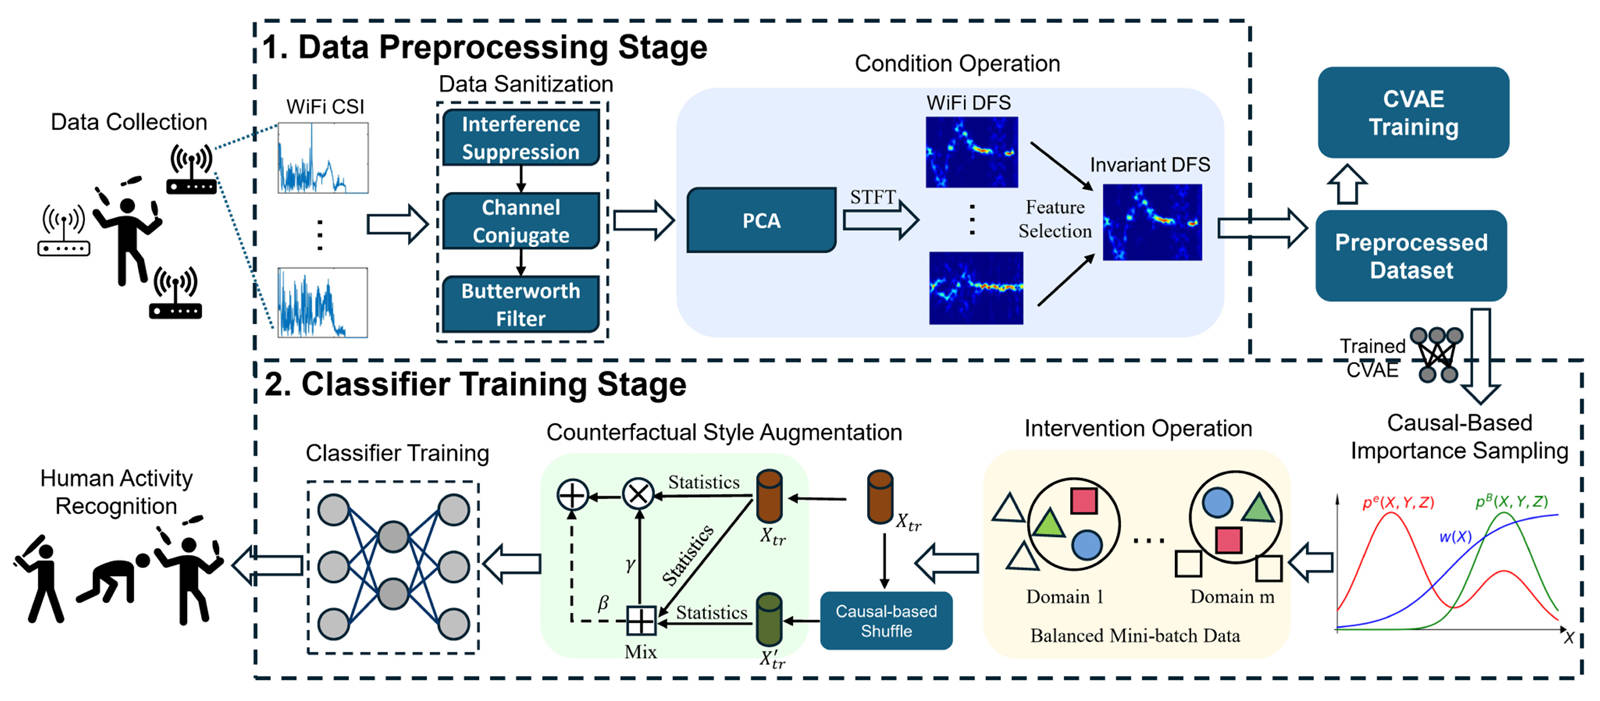
论文代表图:CausalFi: Causality-Based Cross-Domain Human Activity Recognition With Wi-Fi
CausalFi: Causality-Based Cross-Domain Human Activity Recognition With Wi-Fi

Yinan Chen, Yang Zhou, Xiaoxia Huang, Yun Zhang, Yuguang Fang. IEEE Transactions on Networking, vol. 34, pp. 4959-4973, 2026.

简介:面向 Wi-Fi CSI 人体活动识别在跨环境部署时受到潜在混杂因素和域偏移影响的问题,CausalFi 以结构因果模型分解活动、环境风格与 CSI 之间的关系,通过因果特征选择、重要性采样和反事实风格增强提取稳定的动作特征。在多种商用 Wi-Fi 设备和真实跨域场景上的平均识别准确率达到 92.6%,显著优于现有方法。

papercodeprojectdigest
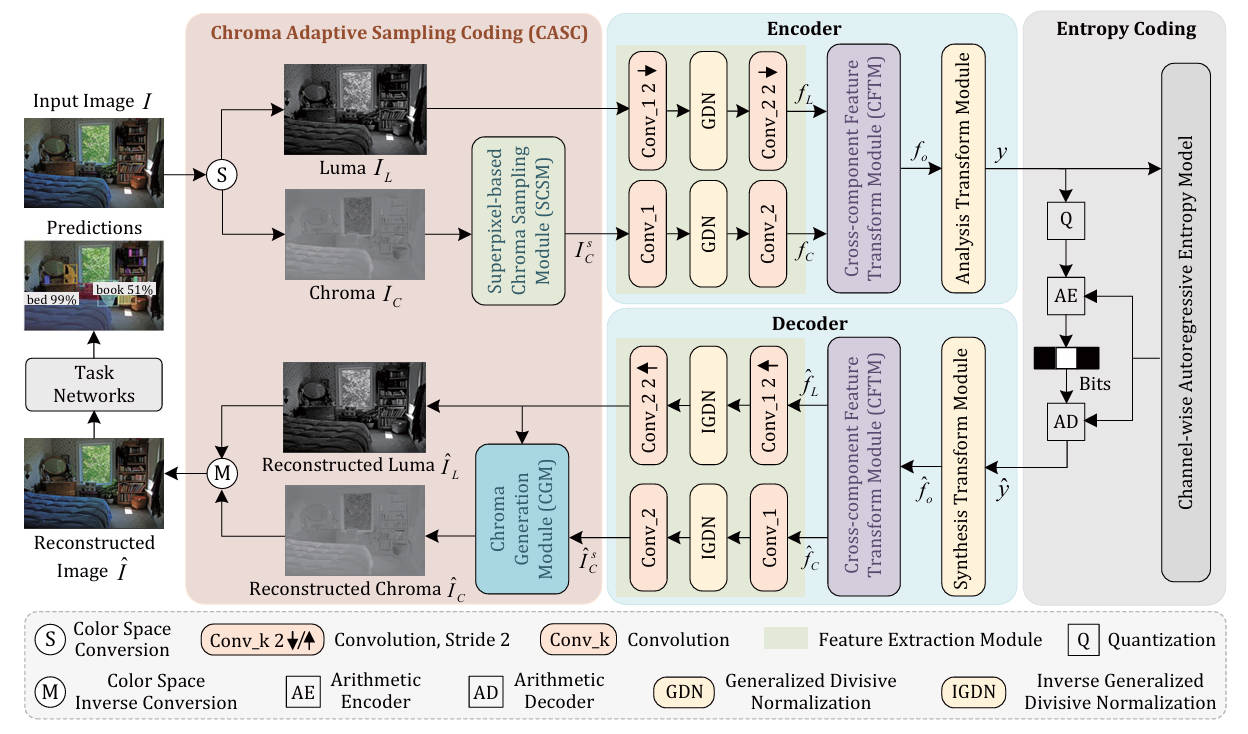
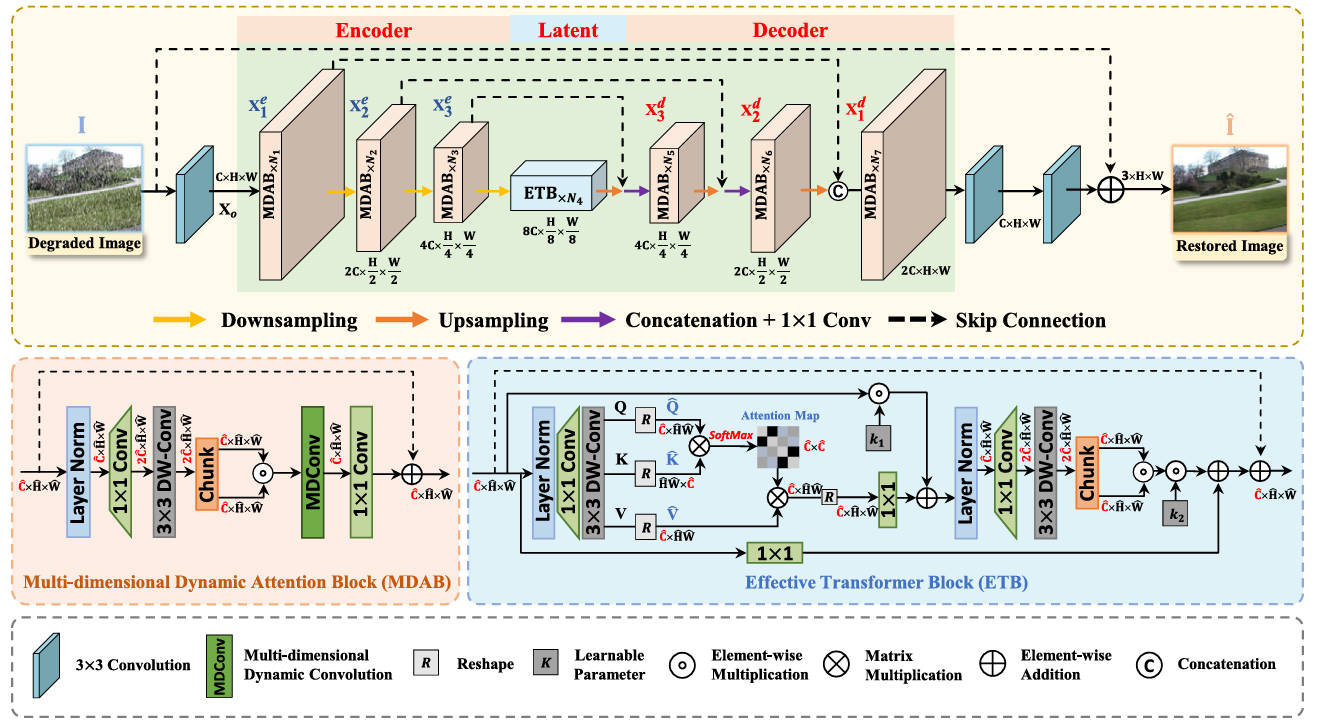
论文代表图:CA-LIC: Chroma-Aware Learned Image Compression for Machines
CA-LIC: Chroma-Aware Learned Image Compression for Machines

Renyi Chen, Liqian Zhang, Yun Zhang, Li Li, Fu Lee Wang, Zhaoqing Pan. IEEE Transactions on Multimedia, 2026.

简介:面向机器视觉的学习式图像压缩,CA-LIC 根据亮度与色度对下游任务贡献的不对称性进行差异化编码。CASC 通过超像素级语义聚合减少色度数据量并利用亮度信息补偿重建色度,CFTM 则建模亮度—色度相关性以抑制跨分量冗余;该方法在目标检测、实例分割和语义分割任务上均取得更优的率—任务性能。

papercodeprojectdigest
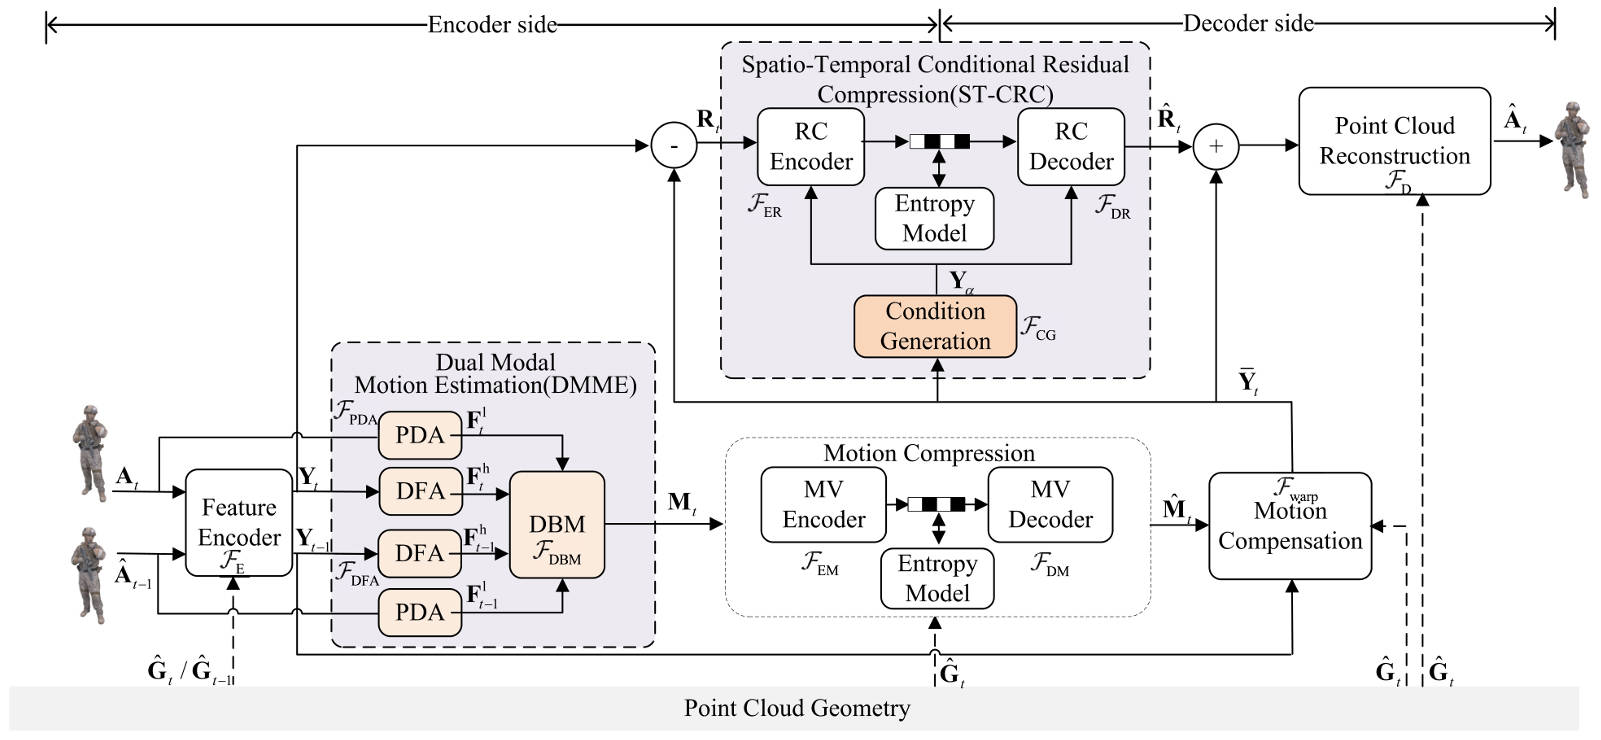
论文代表图:Deep Dynamic Point Cloud Attribute Compression Using Dual-Modal Motion Estimation and Spatio-Temporal Conditional Residual Coding
Deep Dynamic Point Cloud Attribute Compression Using Dual-Modal Motion Estimation and Spatio-Temporal Conditional Residual Coding

Zhiwei Guo, Yun Zhang, Linwei Zhu. IEEE Transactions on Broadcasting, vol. 72, no. 3, pp. 877-889, 2026.

简介:提出端到端动态点云属性压缩框架 DD-PCAC,在统一可微流程中联合完成运动估计、运动补偿与残差编码。DMME 融合动态球匹配、像素域聚合和深层特征聚合,ST-CRC 利用时空条件提高残差压缩效率;相比 TSC-PCAC 和 G-PCC,平均码率分别降低 31.57% 和 30.33%。

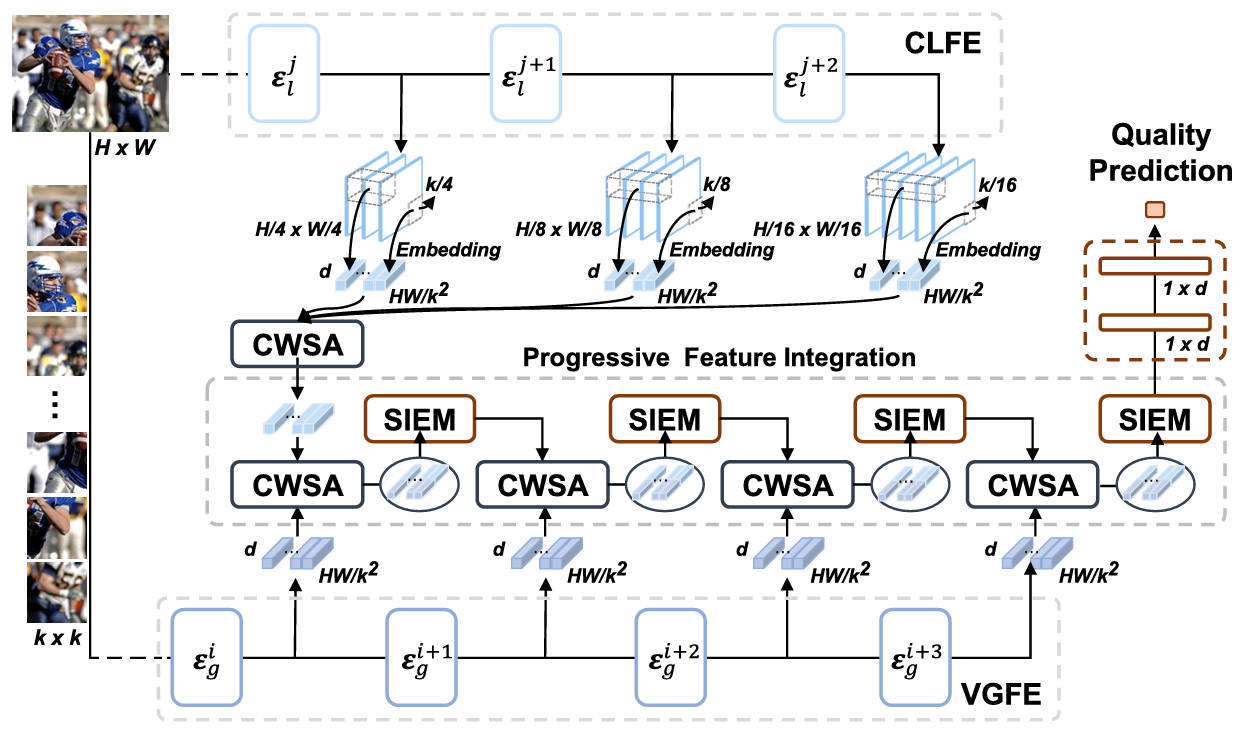
论文代表图:Global–Local Progressive Integration and Semantic-Aligned Quality Transfer for No-Reference Image Quality Assessment
Global–Local Progressive Integration and Semantic-Aligned Quality Transfer for No-Reference Image Quality Assessment

Xiaoqi Wang, Yun Zhang. ACM Transactions on Multimedia Computing, Communications and Applications, 2026.

简介:提出无参考图像质量评价模型 GlintIQA,以 ViT 捕获全局上下文、CNN 提取局部细粒度失真,并通过通道自注意与空间交互模块渐进融合多尺度特征。研究还提出 SAQT 质量迁移方法,在语义相似且失真一致的图像间迁移主观分数以构建大规模训练集,显著提升模型的跨数据集泛化能力。

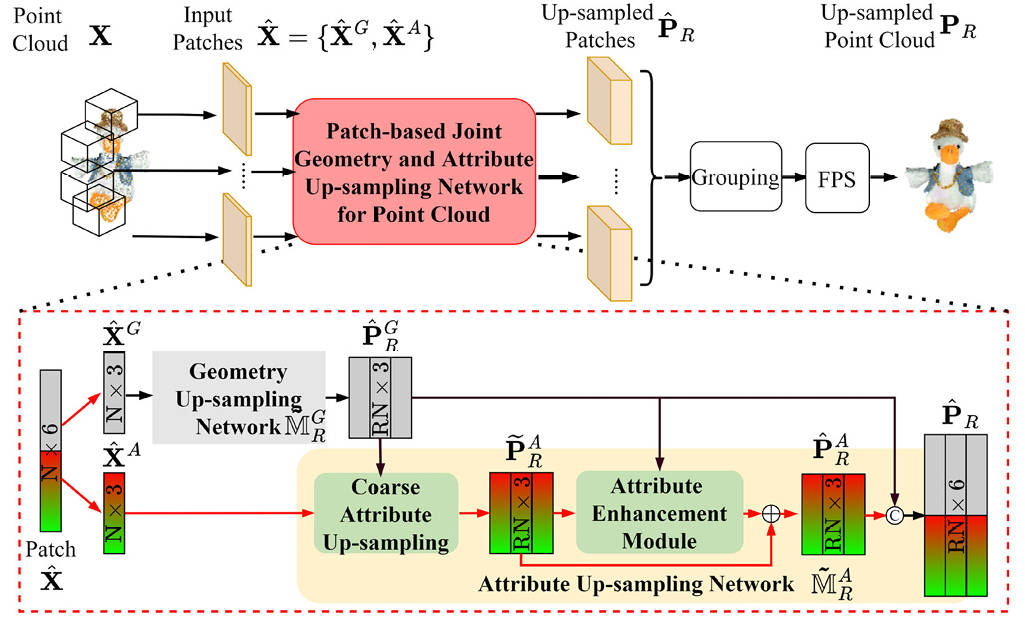
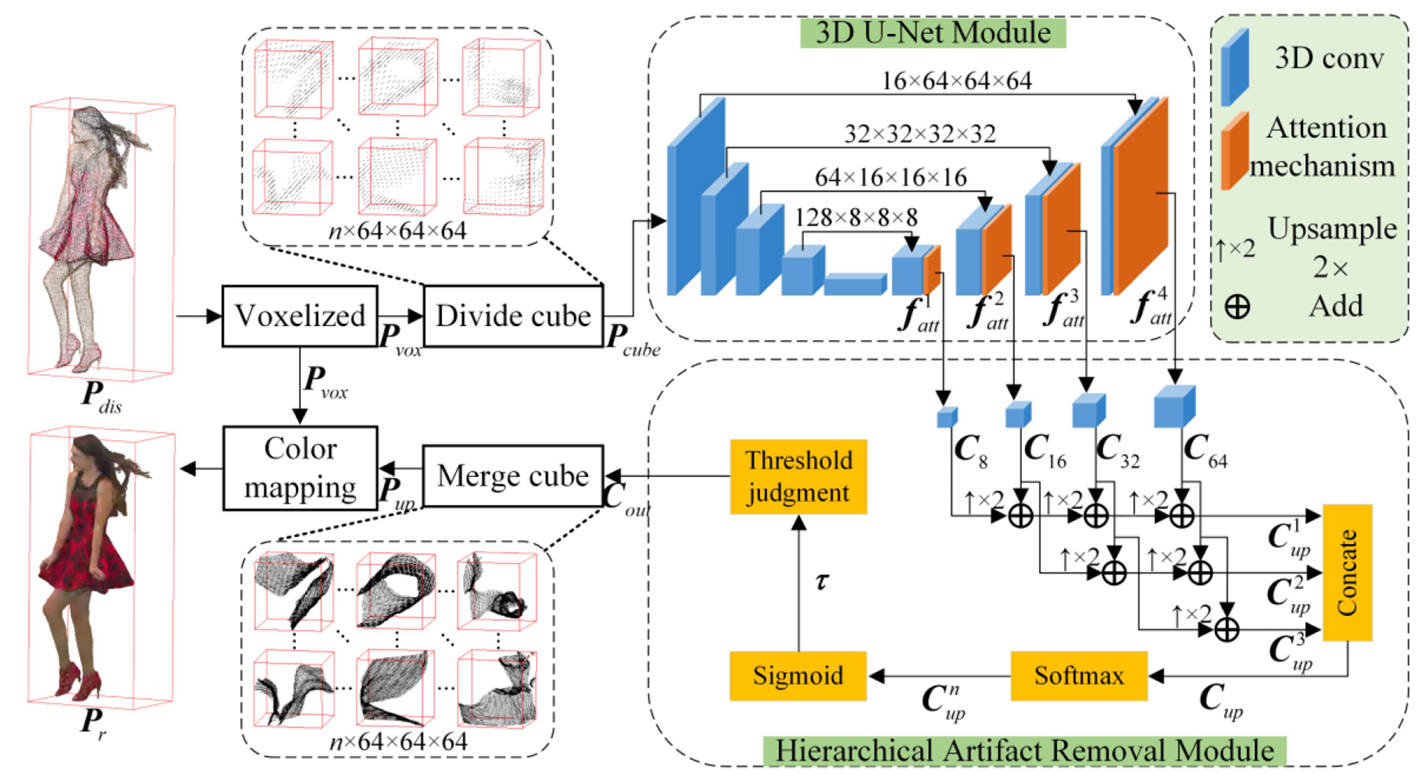
论文代表图:Deep Learning based Joint Geometry and Attribute Upsampling for Large-Scale Colored Point Clouds
Deep Learning based Joint Geometry and Attribute Upsampling for Large-Scale Colored Point Clouds

Yun Zhang, Feifan Chen, Na Li, Xu Wang, Fen Miao, Sam Kwong. IEEE Transactions on Image Processing, vol. 35, pp. 1305-1320, 2026.

简介:提出联合几何与属性上采样框架 JGAU,利用二者的空间相关性恢复稠密点云。研究同时构建大规模彩色点云上采样数据,为不同放大倍率下的模型训练与评测提供支持。

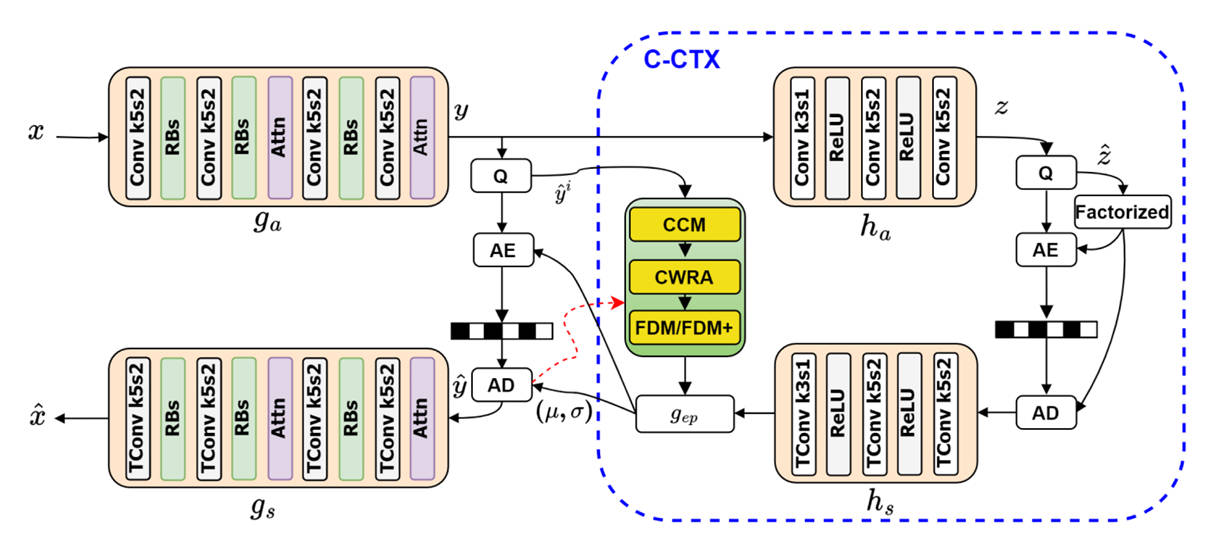
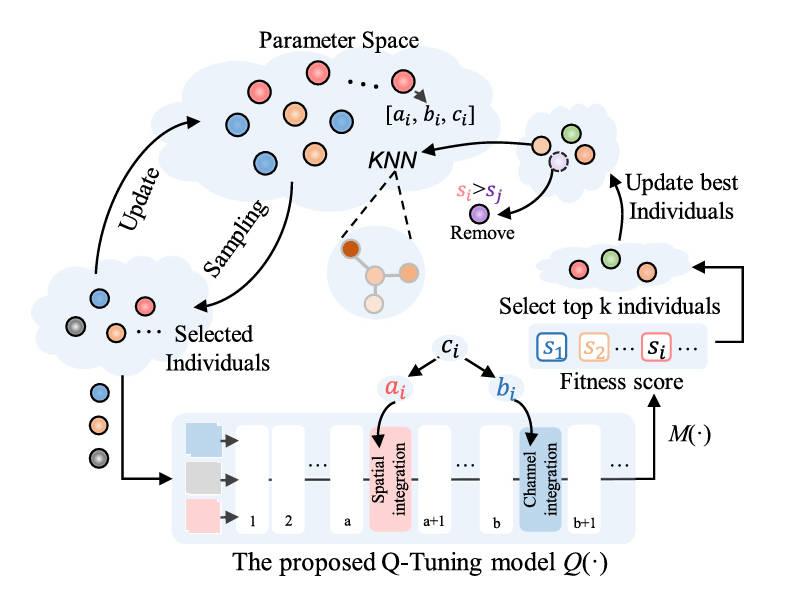
论文代表图:C-CTX: Cubic-Checkerboard Context Entropy Model for Learned Image Compression
C-CTX: Cubic-Checkerboard Context Entropy Model for Learned Image Compression

Shiyu Feng, Linwei Zhu, Yun Zhang, Na Li, Wenhui Wu, Shiqi Wang. IEEE Transactions on Multimedia, vol. 28, pp. 1756-1766, 2026.

简介:提出立方棋盘上下文熵模型 C-CTX,在空间和通道维度统一组织与引用潜变量。通过通道重排和多种上下文预测方式,模型能够获得更准确的概率估计并改善学习式图像压缩性能。

papercodeprojectdigest
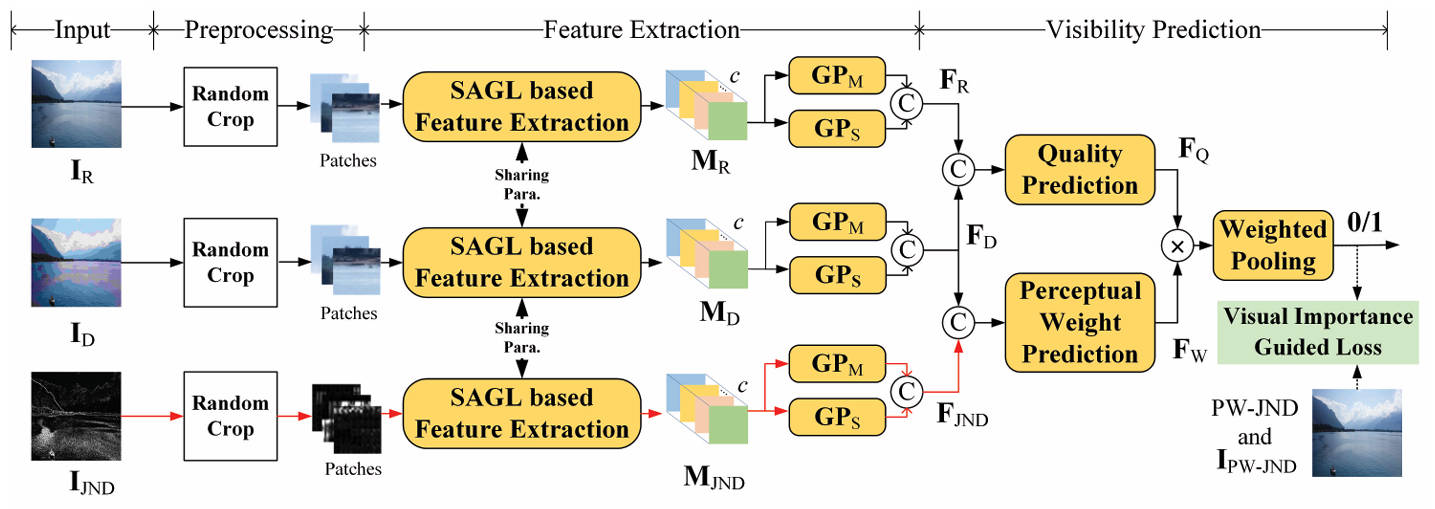
论文代表图:VP-JND: Visual Perception Assisted Deep Picture-Wise Just Noticeable Distortion Prediction Model for Image Compression
VP-JND: Visual Perception Assisted Deep Picture-Wise Just Noticeable Distortion Prediction Model for Image Compression

Yun Zhang, Shisheng Zhang, Na Li, Chunling Fan, Raouf Hamzaoui. IEEE Transactions on Circuits and Systems for Video Technology, vol. 36, no. 1, pp. 622-636, 2026.

简介:提出图像级 VP-JND 预测模型,估计人眼刚好能够察觉的失真阈值。预测结果可用于指导编码参数和码率分配,在减少视觉冗余的同时尽量保持主观质量。

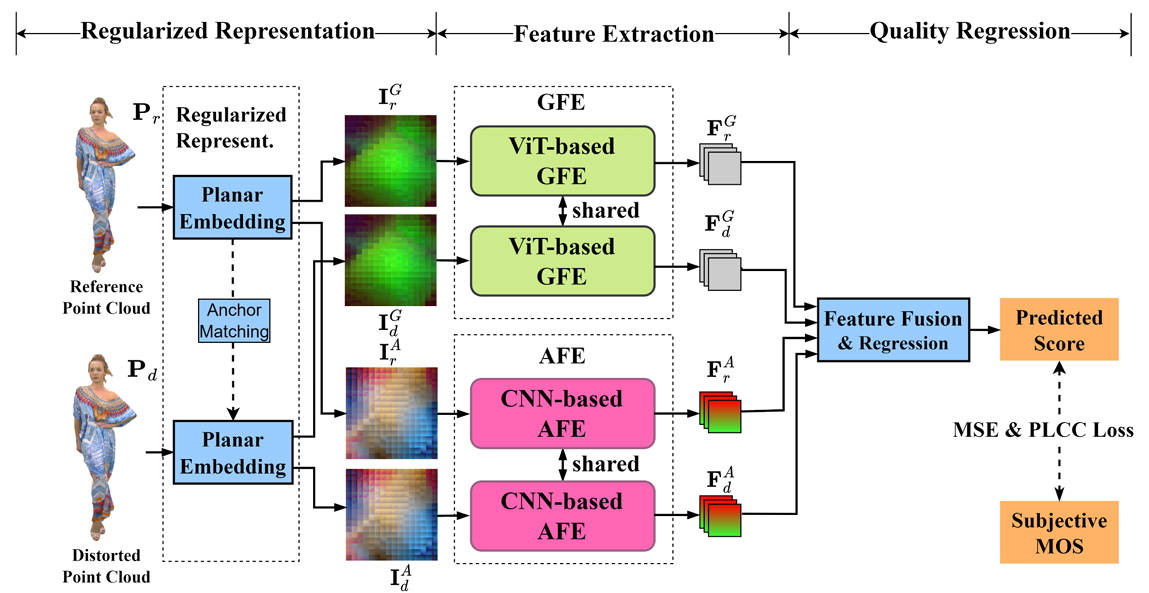
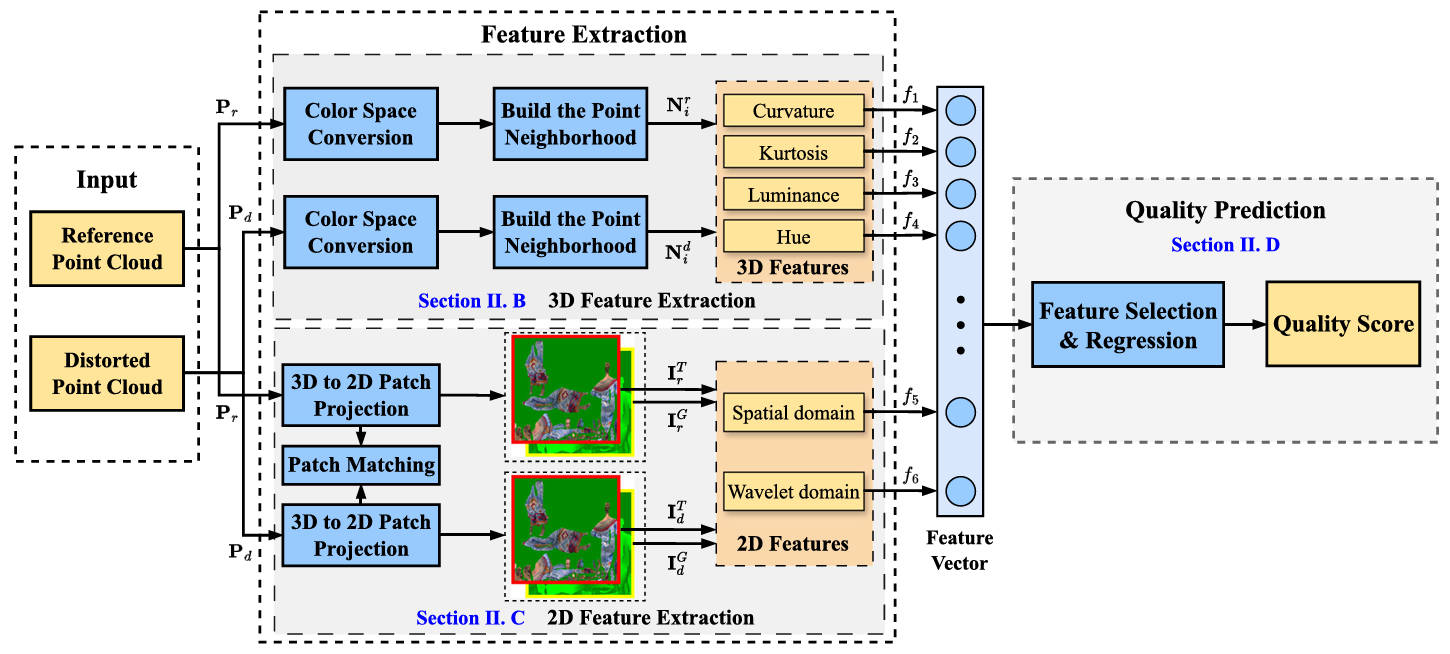
论文代表图:RegR-PCQA: Deep Learning based Colored Point Cloud Quality Assessment Using 3D-to-2D Regularized Representation
RegR-PCQA: Deep Learning based Colored Point Cloud Quality Assessment Using 3D-to-2D Regularized Representation

Yun Zhang, Cui Mao, Na Li, Chunling Fan, Weisi Lin. IEEE Transactions on Multimedia, vol. 28, pp. 1894-1908, 2026.

简介:将彩色点云规则化映射到二维几何图和属性图,再分别提取互补特征。框架结合 ViT 几何建模、CNN 属性建模与质量回归,实现面向彩色点云的客观质量评价。

papercodeprojectdigest
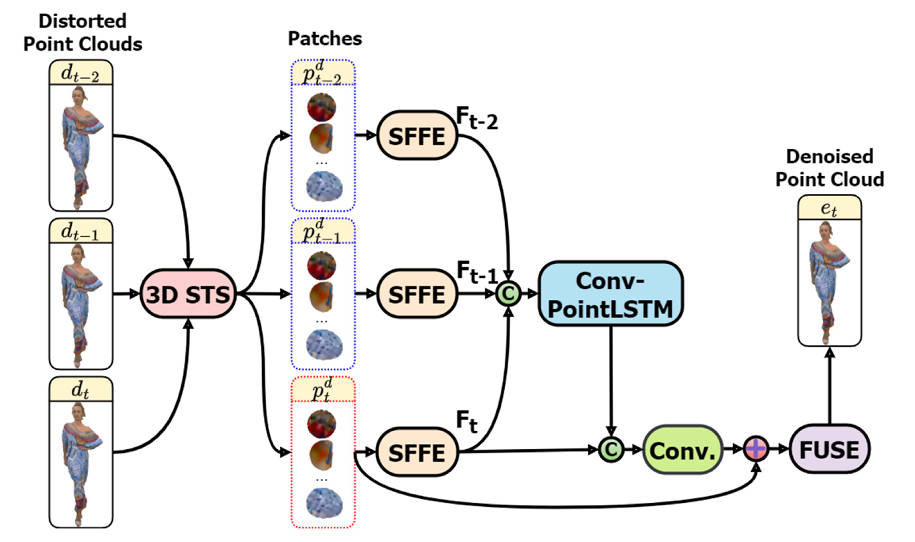
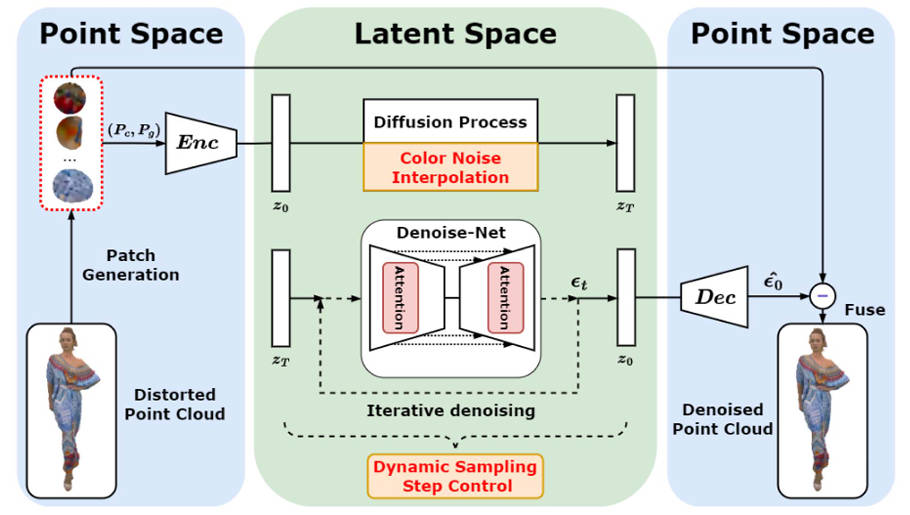
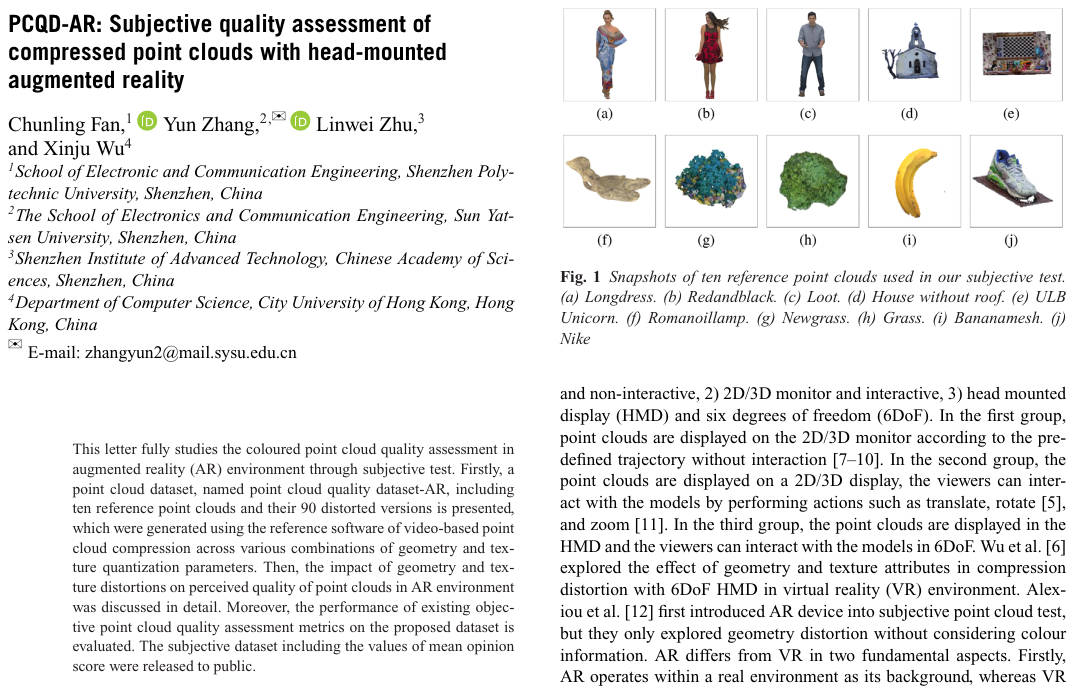
论文代表图:Temporal Consistency-Aware Dynamic Point Clouds Color Attribute Enhancement
Temporal Consistency-Aware Dynamic Point Clouds Color Attribute Enhancement

Linwei Zhu, Ruxu Liang, Yun Zhang, Hui Yuan, Sam Kwong. IEEE Transactions on Multimedia, 2026.

简介:针对动态点云颜色属性在连续帧中的噪声与闪烁,设计三维时空搜索和时序特征融合流程。方法结合局部特征提取与 Conv-PointLSTM,利用帧间一致性恢复更稳定的颜色信息。

papercodeprojectdigest
180+SCI / EI

论文

研究覆盖视觉编码、感知质量、三维视觉和智能媒体等方向,其中 IEEE/ACM Transactions 论文 70 余篇。

1学术专著

专著

出版学术专著《三维视频处理》,系统梳理三维视频表示、编码与处理技术。

50+发明专利

专利

授权中国、美国及 PCT 发明专利 50 余项,推动研究成果向技术应用转化。