SYSU · SECE · IMEDIACODEC LAB
iMediaCodec Lab
We investigate efficient compression, intelligent analysis, and immersive presentation of visual data, with research spanning image/video coding and communication, visual perception, 3D video, VR/AR, and AI-powered visual applications.
Visual Perception Modeling
Intelligent Visual Coding and Communication
3D Visual Coding and Computing
Artificial Intelligence and Visual Applications
About
About Our Team
Led by Prof. Yun Zhang, iMediaCodec Lab conducts long-term research in visual perception modeling, intelligent visual coding and communication, 3D visual coding and computing, and AI-powered visual applications.
Visual Perception Modeling
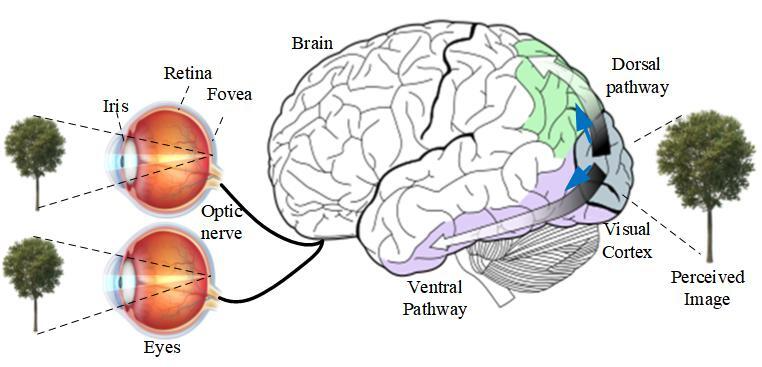
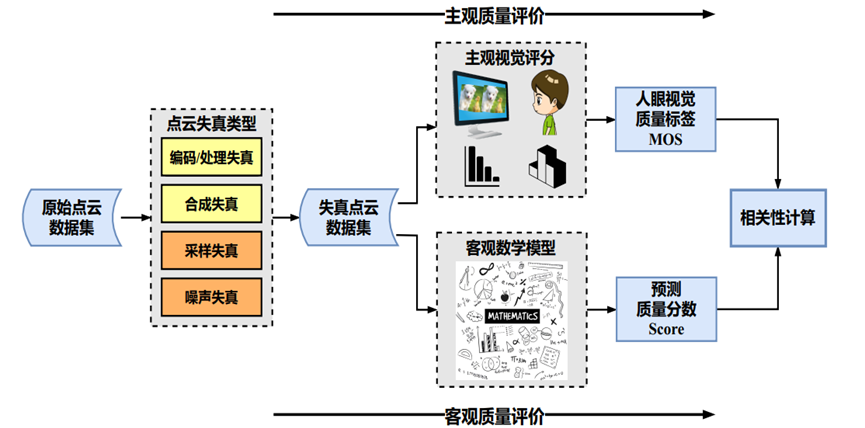
We study the mechanisms and computational modeling of human vision, with emphasis on image quality assessment (IQA), video quality assessment (VQA), and point cloud quality assessment for perceptual representation and quality prediction across visual media.
Intelligent Visual Coding and Communication
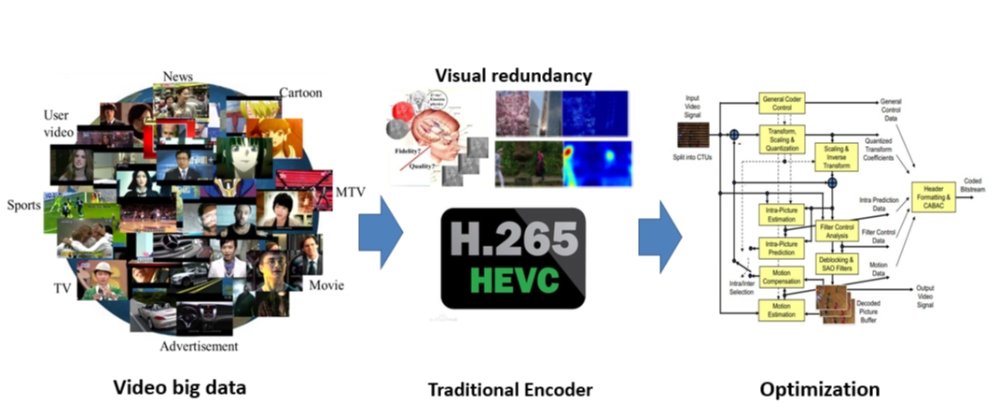
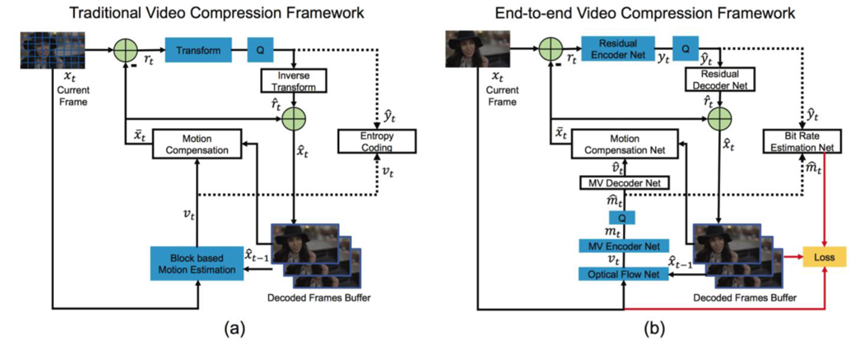
We investigate learned image compression (LIC), neural video coding (NVC), and image compression for machine vision, enabling joint optimization of perception, coding, and communication for efficient storage, transmission, and machine analysis.
3D Visual Coding and Computing
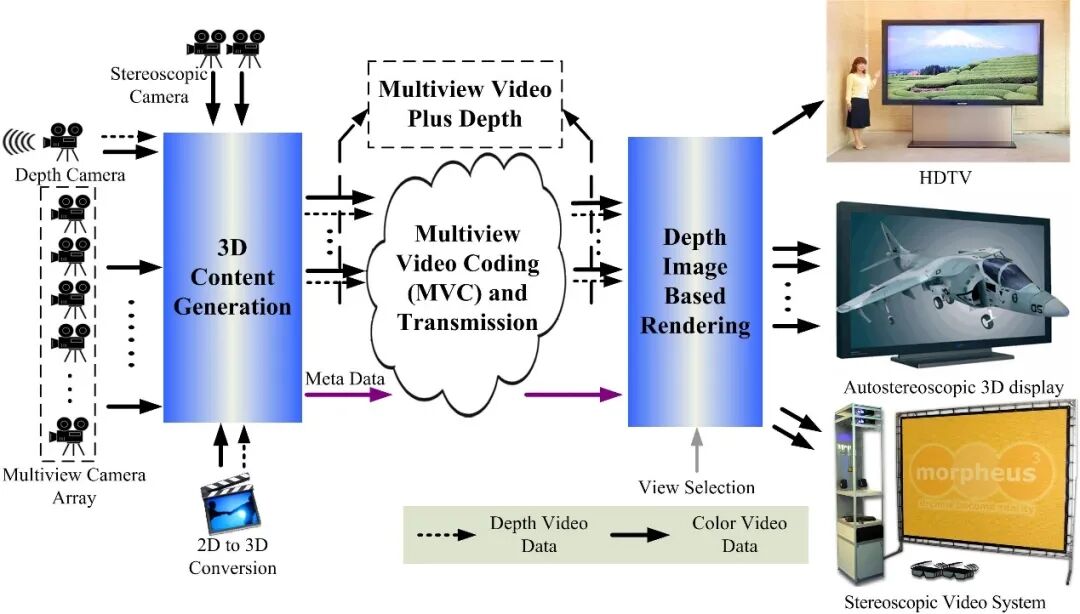
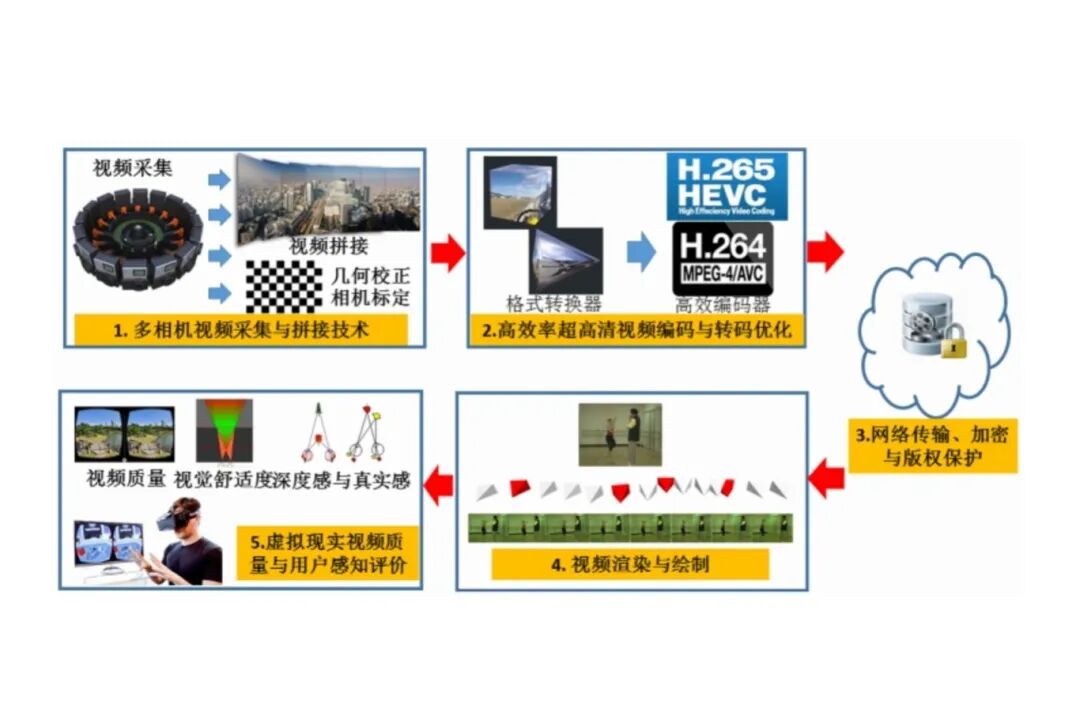
We explore the representation, compression, and reconstruction of 3D scenes through 3D video, point cloud coding and enhancement, virtual reality (VR), augmented reality (AR), and 3D Gaussian techniques for efficient immersive media delivery.
Artificial Intelligence and Visual Applications
We develop methods for image enhancement and restoration, video understanding and generation, vision-language modeling, and intelligent visual systems, advancing AI applications in visual analysis, content generation, and real-world scenarios.
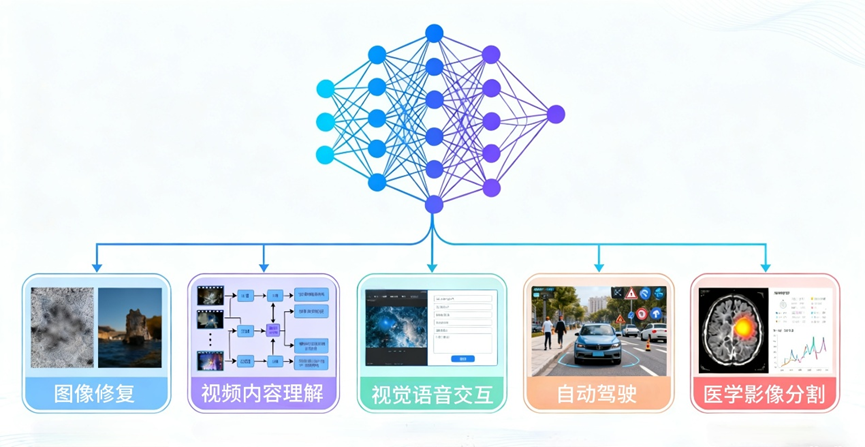
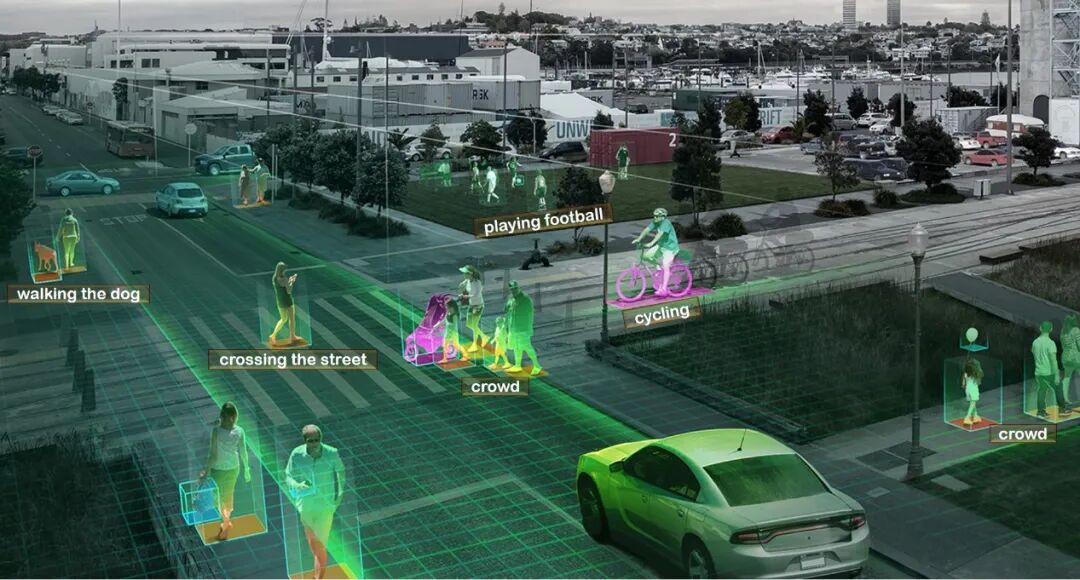
Swipe horizontally to browse; select a poster for a larger view.
News
Latest News
- Call for Papers: Recent Advances in Media Computing | Discover Computing
- Professor Patrick Le Callet of Nantes Université Gives an Invited Academic Lecture at the School
- Faculty and Students from the Team Attend China Multimedia 2026 (ChinaMM 2026)
- Faculty and Students from the Team Attend The 2nd International Symposium on Machine Learning and Media Computing (MLMC 2026)
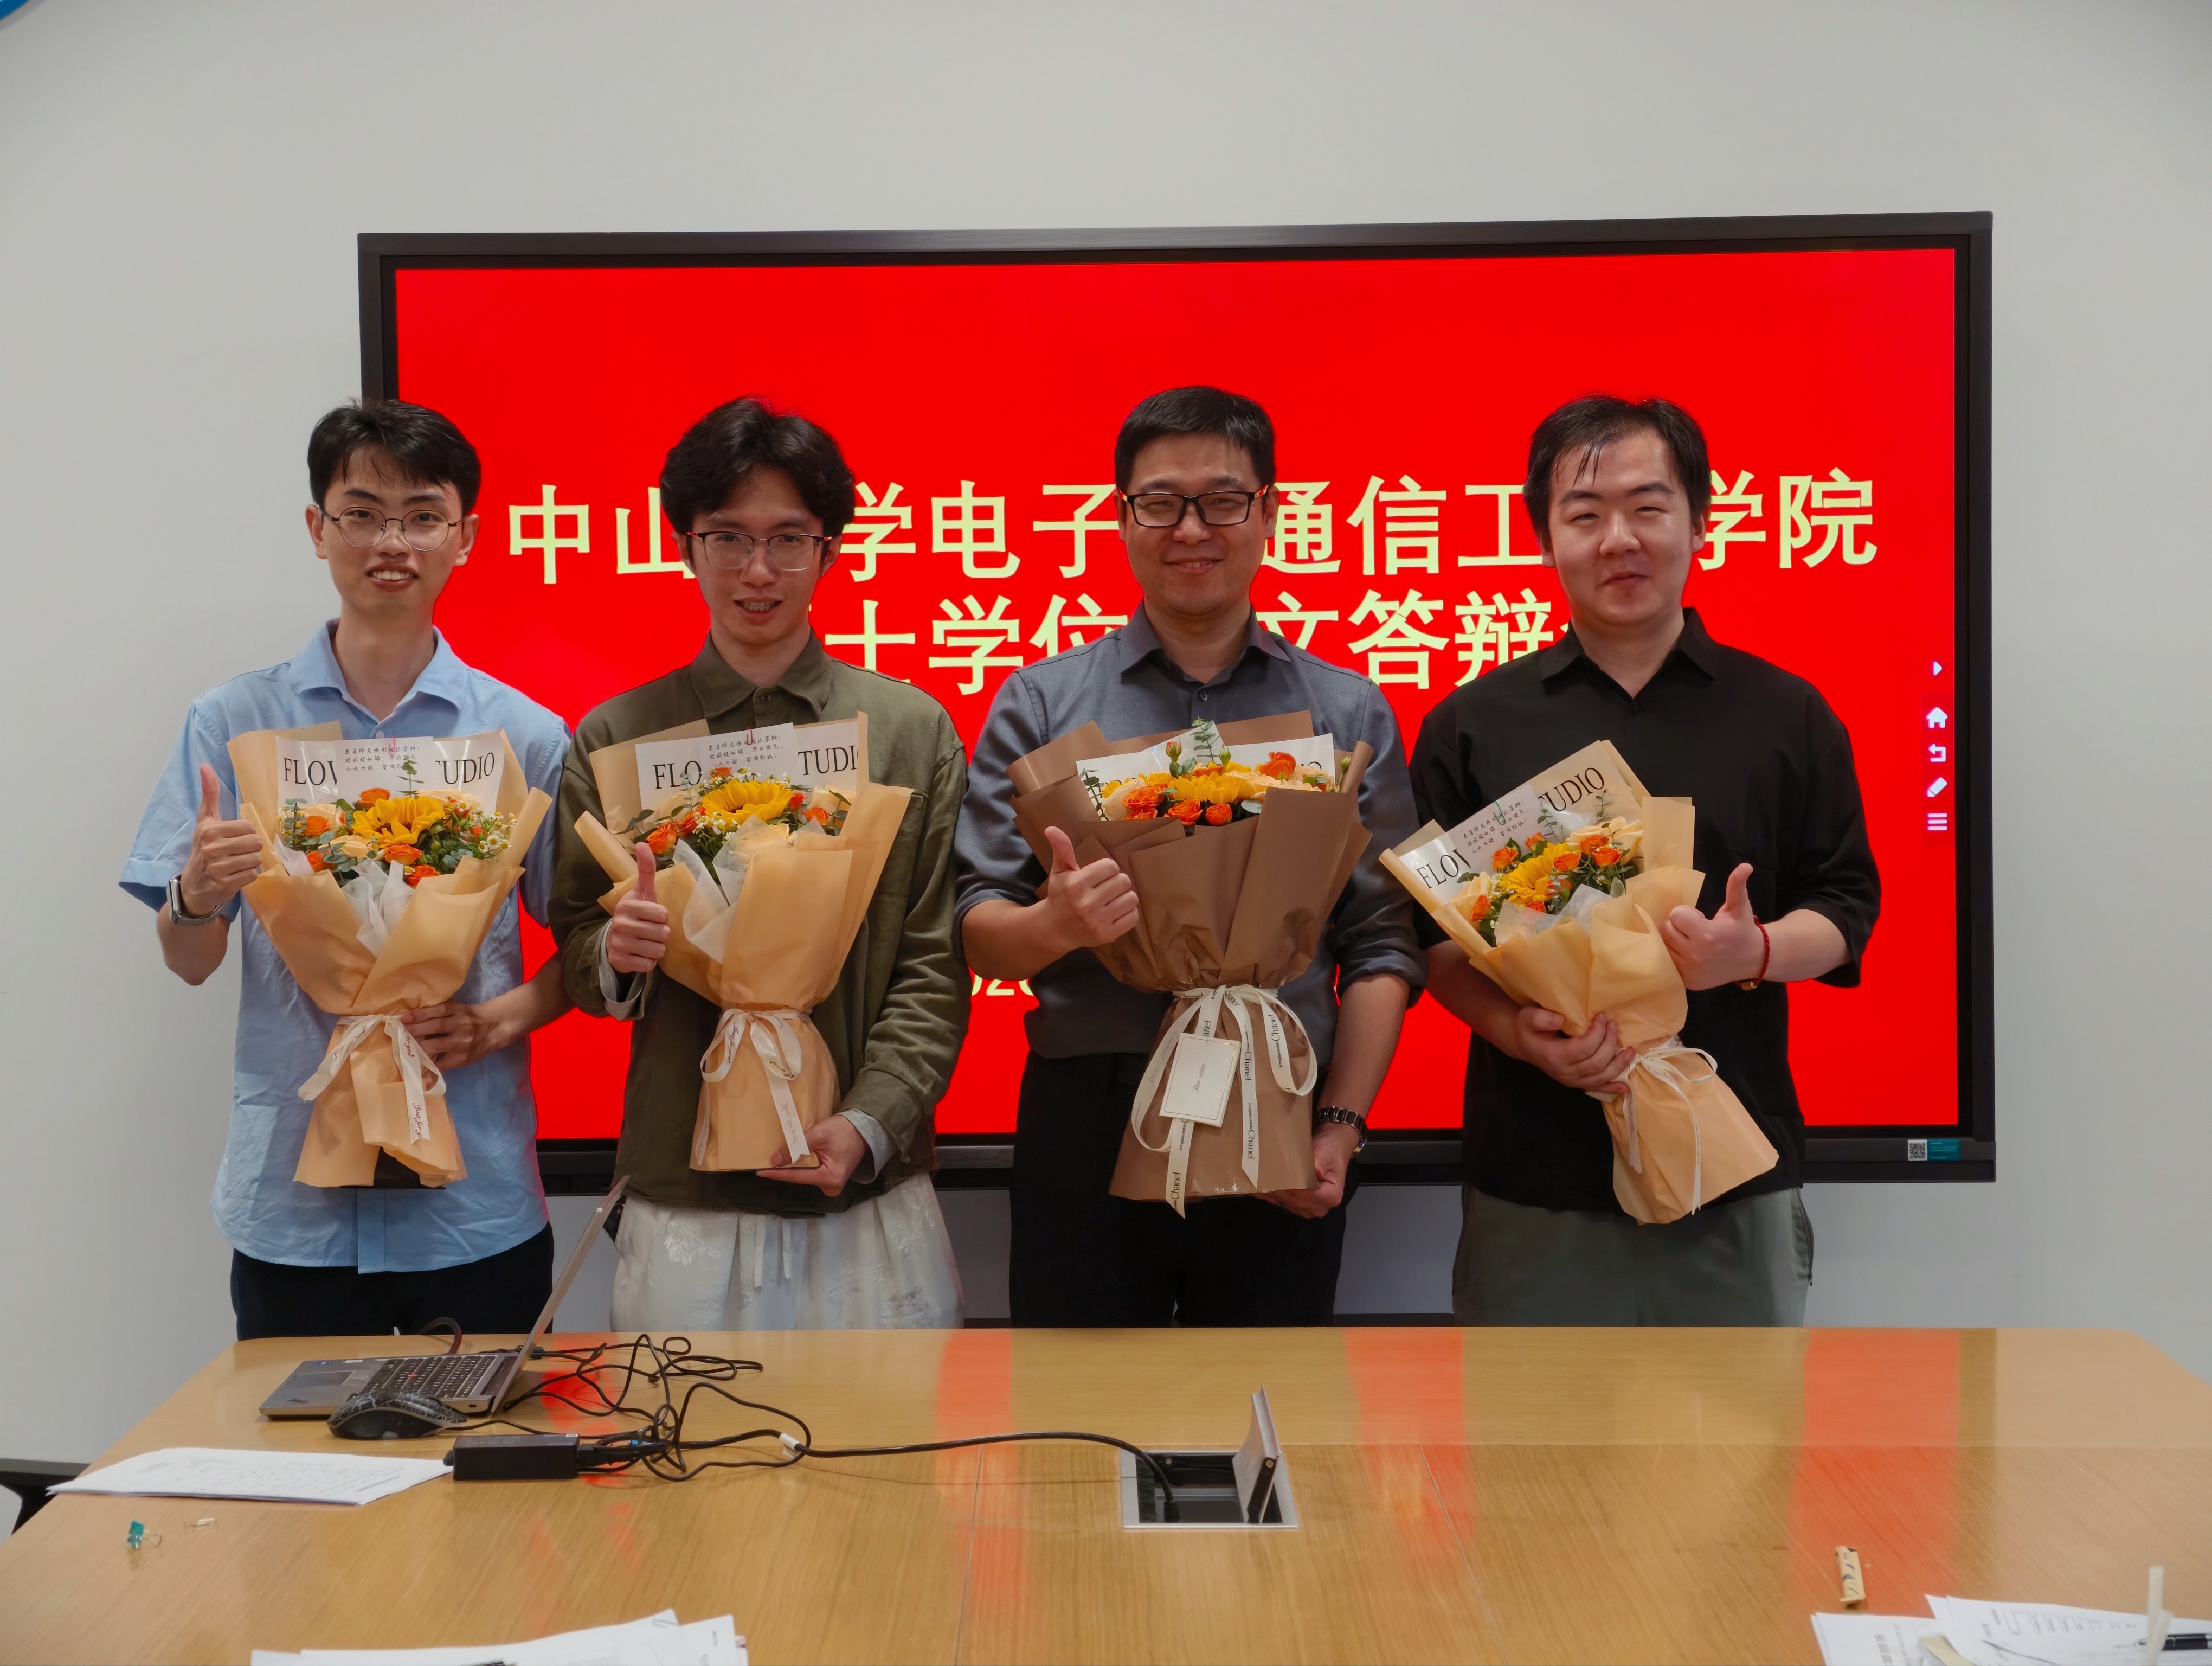
- Congratulations to three team members on successfully completing their master's thesis defenses!
- Congratulations! Our paper “Deep-JGAC: End-to-End Deep Joint Geometry and Attribute Compression for Dense Colored Point Clouds” was published in IEEE Transactions on Circuits and Systems for Video Technology.
- Congratulations! Our paper “Rate-Reconfigurable Deep Point Cloud Compression with Perceptual Bit Allocation Optimization” was published in IEEE Transactions on Image Processing.
- Six team members attended the China Congress on Image and Graphics (CCIG 2026).
- The iMediaCodec Lab website is now live. We welcome collaboration in intelligent visual coding, point cloud compression, machine-vision quality assessment, VR/AR, and generative visual applications. Ph.D. and master's applicants, as well as outstanding undergraduates interested in research training, are encouraged to contact us.
Paper Insights
Paper Insights
- 17Point Cloud CompressionPerceptually Optimized Bit Allocation Between Attribute and Geometry for Video-Based Point Cloud Compression
- 16Image QualityGlobal-Local Progressive Integration and Semantic-Aligned Quality Transfer for No-Reference Image Quality Assessment
- 15Point Cloud CompressionDeep Dynamic Point Cloud Attribute Compression Using Dual-Modal Motion Estimation and Spatio-Temporal Conditional Residual Coding
- 14Point Cloud CompressionDeep-JGAC: End-to-End Deep Joint Geometry and Attribute Compression for Dense Colored Point Clouds
- 13Point Cloud CompressionRate-Reconfigurable Deep Point Cloud Compression With Perceptual Bit Allocation Optimization
- 12Point Cloud UpsamplingDeep Learning based Joint Geometry and Attribute Upsampling for Large-Scale Colored Point Clouds
- 11Point Cloud CompressionTSC-PCAC: Voxel Transformer and Sparse Convolution-Based Point Cloud Attribute Compression for 3D Broadcasting
- 10Conference SpecialPaper Highlights from the 2025 IEEE International Symposium on Machine Learning and Media Computing (MLMC'2025)
- 09Point Cloud DenoisingGeometry-Guided Latent Diffusion Model for Static Point Cloud Color Attribute Denoising
- 08Light Field CompressionLFIC-DRASC: Deep Light Field Image Compression Using Disentangled Representations and Asymmetrical Strip Convolution
- 07Point Cloud QualityRegR-PCQA: Deep Learning based Colored Point Cloud Quality Assessment Using 3D-to-2D Regularized Representation
- 06Point Cloud QualityColored Point Cloud Quality Assessment Using Complementary Features in 3D and 2D Spaces
- 05Image QualityMulti-Granular Embedding Optimization with Spatial-Channel Adaptive Tuning for Perceptual Image Quality Assessment
- 04Feature CodingMulti-scale Feature Importance-based Bit Allocation for End-to-End Feature Coding for Machines
- 03Perceptual CodingVP-JND: Visual Perception Assisted Deep Picture-Wise Just Noticeable Distortion Prediction Model for Image Compression
- 02Machine Vision CodingDT-JRD: Deep Transformer based Just Recognizable Difference Prediction Model for Video Coding for Machines
- 01Perceptual CodingLearning to Predict Object-Wise Just Recognizable Distortion for Image and Video Compression