SYSU · SECE · IMEDIACODEC LAB
智能媒体编码实验室
团队围绕视觉数据的高效压缩、智能分析与沉浸式呈现,开展图像/视频编码与通信、视觉感知计算、三维视频、VR/AR 以及人工智能视觉应用研究。
视觉感知建模
智能视觉编码与通信
三维视觉编码与计算
人工智能及其视觉应用
About
团队简介
智能媒体编码实验室由中山大学电子与通信工程学院张云教授负责,长期从事视觉感知建模、智能视觉编码与通信、三维视觉编码与计算、人工智能及其视觉应用等方向研究。
视觉感知建模
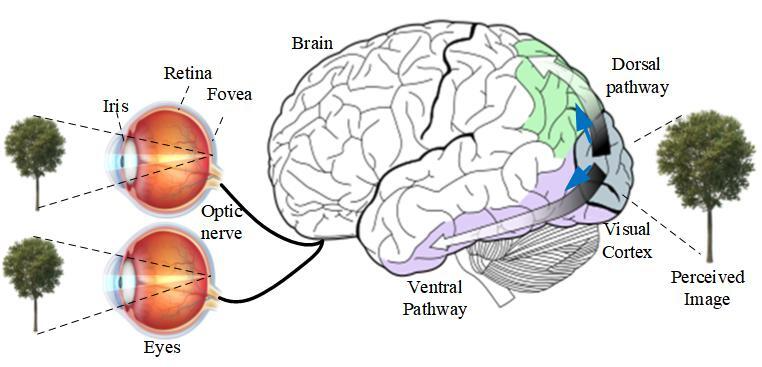
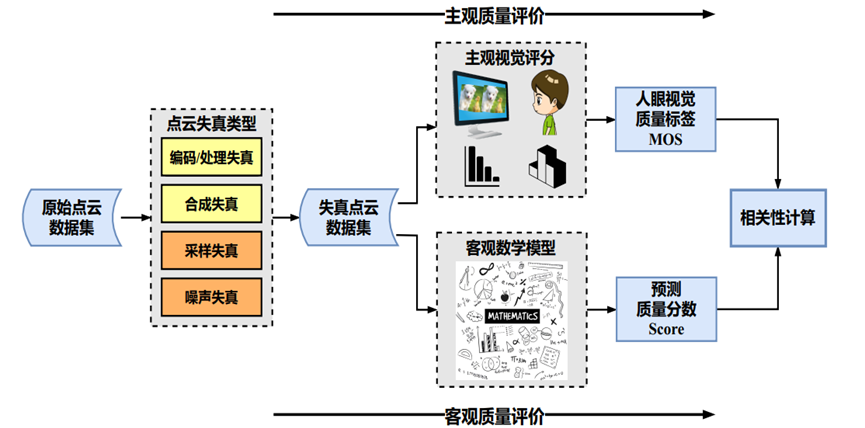
围绕人类视觉机理与计算建模,研究图像质量评价(IQA)、视频质量评价(VQA)及点云质量评价方法,建立面向多类型视觉数据的感知质量表征与预测模型。
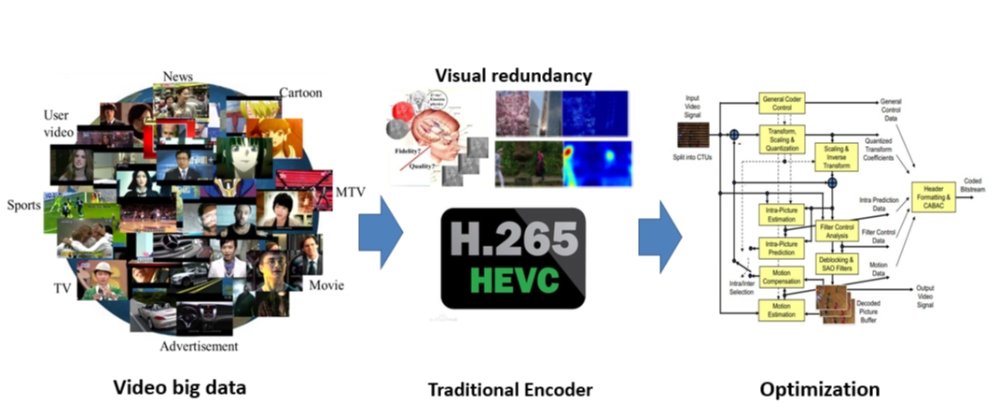
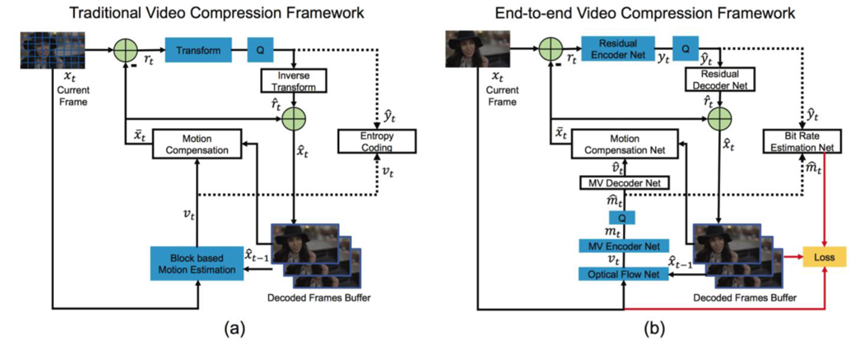
智能视觉编码与通信
面向视觉数据的高效存储、传输与机器分析,研究学习型图像编码(LIC)、神经视频编码(NVC)以及面向机器视觉的图像压缩,推动感知、编码与通信协同优化。
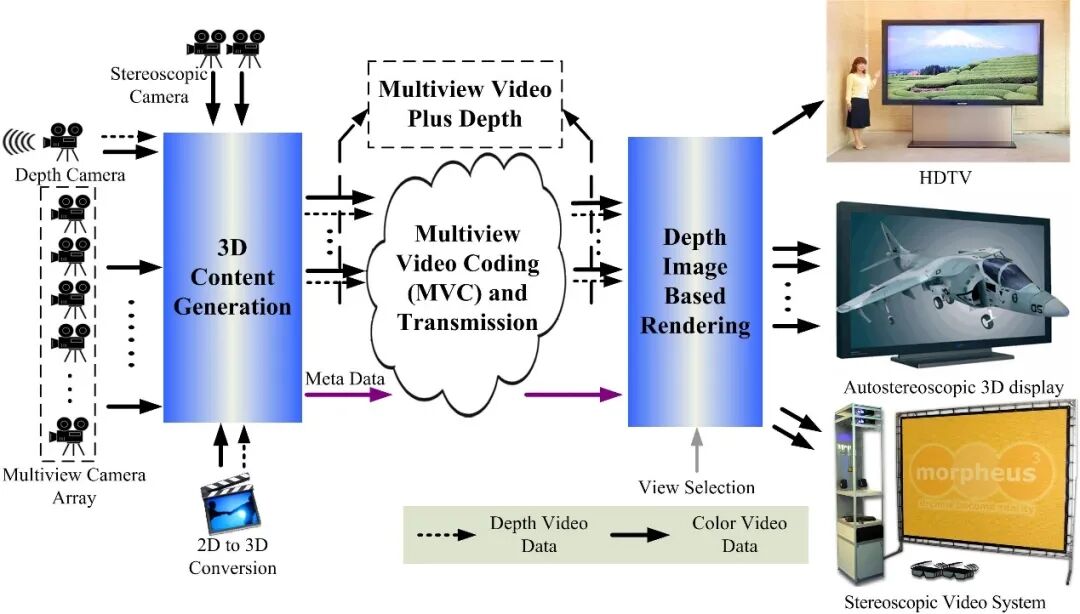
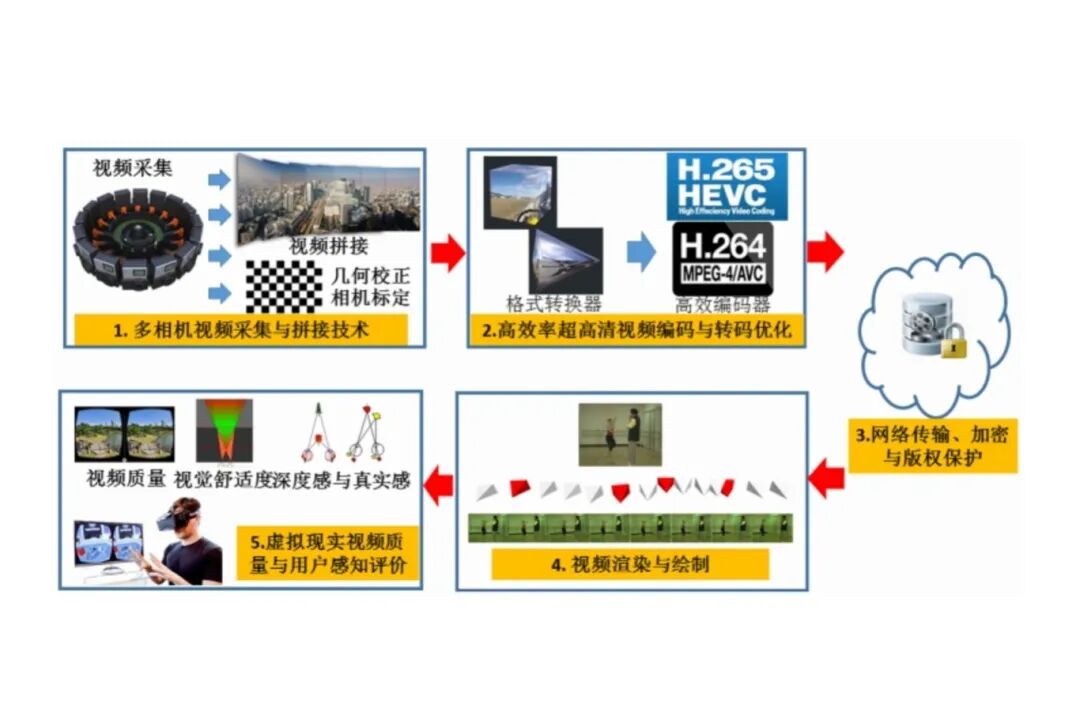
三维视觉编码与计算
面向三维场景的表示、压缩与重建,开展三维视频、点云编码与增强、虚拟现实(VR)、增强现实(AR)和 3D 高斯等研究,提升沉浸式内容的传输与呈现效率。
人工智能及其视觉应用
研究图像增强与修复、视频理解与生成、视觉—语言建模及智能视觉系统,探索人工智能技术在视觉内容分析、生成和行业场景中的应用。
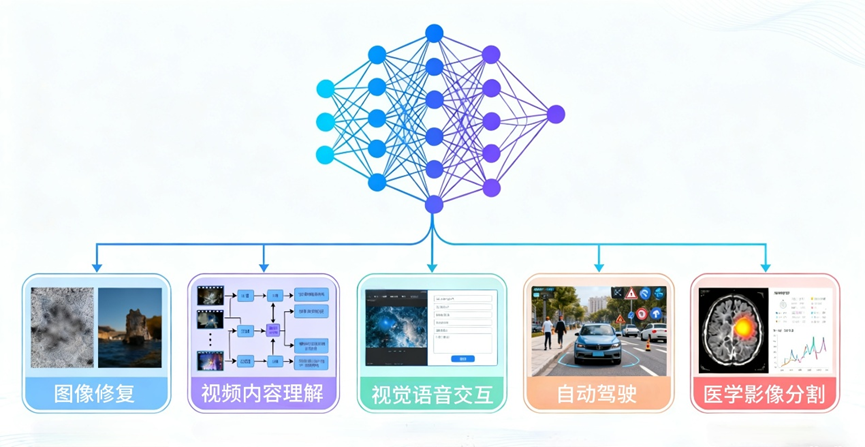
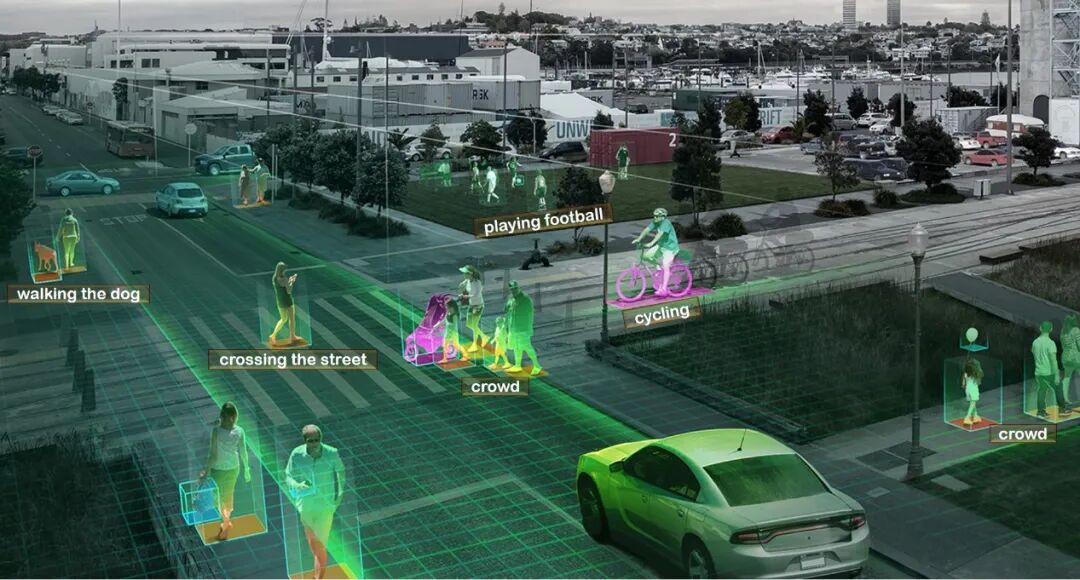
左右滑动浏览,点击海报查看大图
News
近期信息
- Discover Computing专刊征稿:媒体计算最新进展
- 法国南特大学Patrick Le Callet教授应邀来我院做学术报告
- 团队师生参加2026中国多媒体大会 (ChinaMM 2026)
- 团队师生参加第二届机器学习与媒体计算国际研讨会 (MLMC 2026)
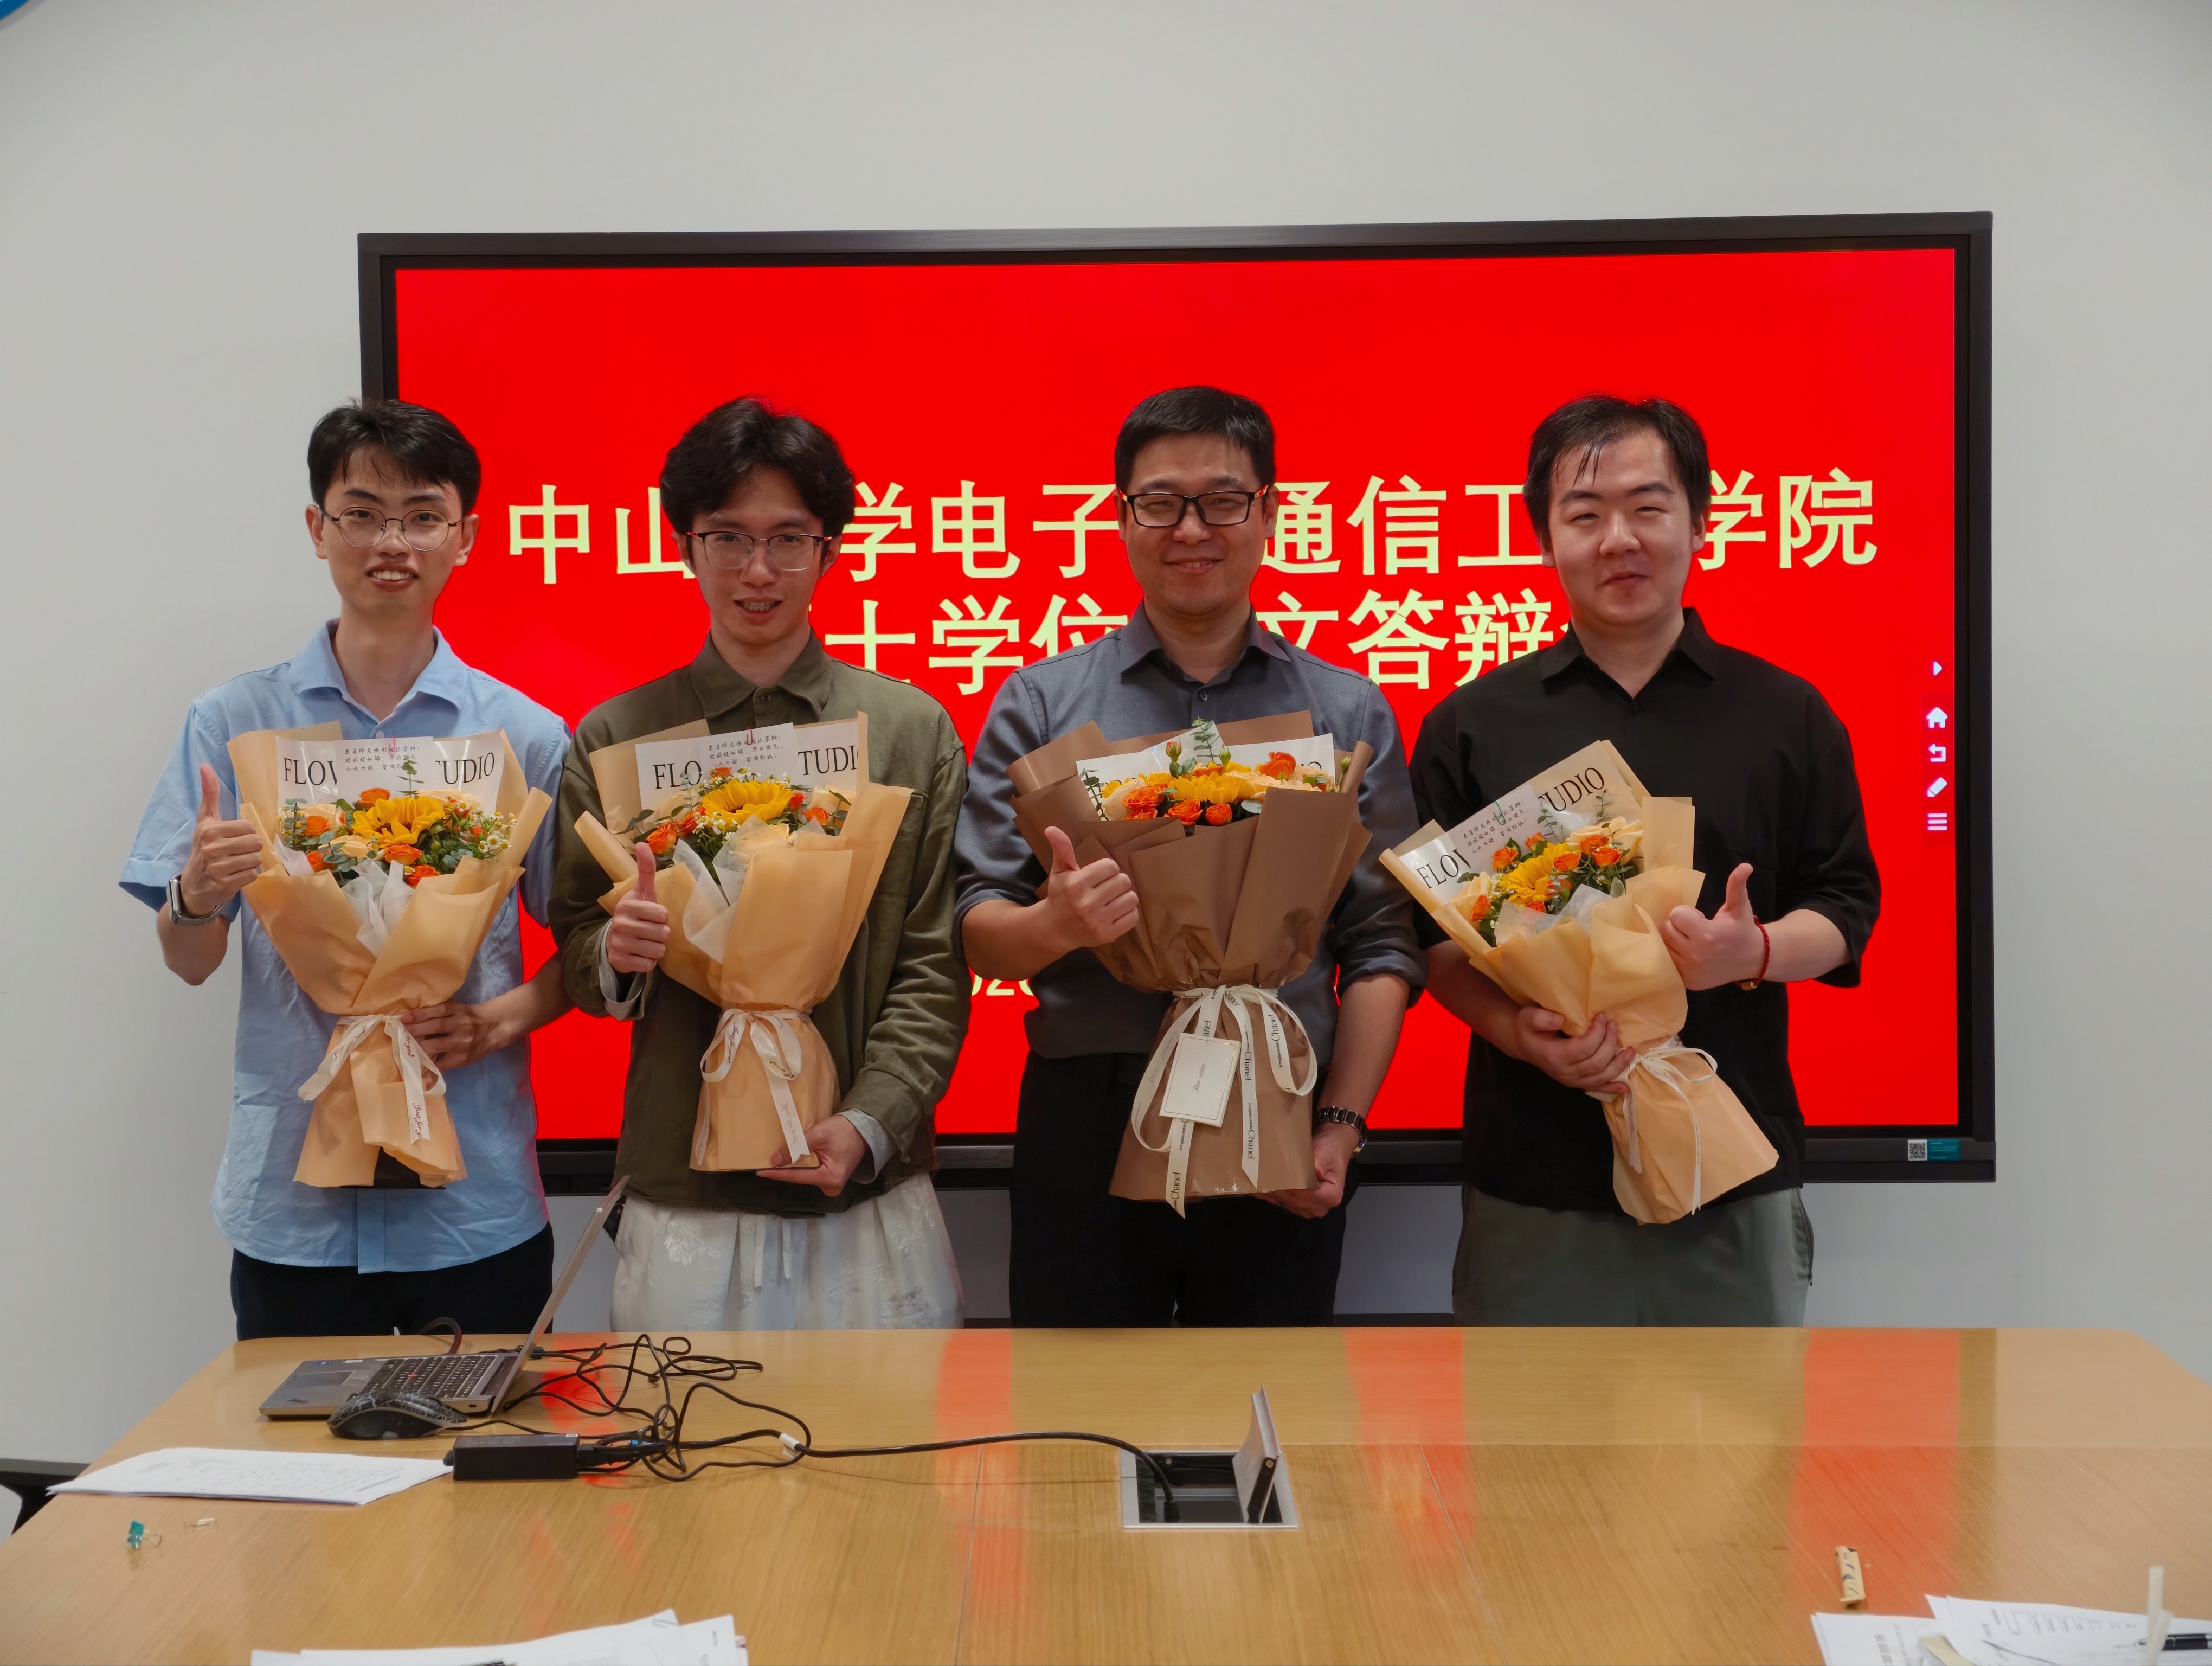
- 祝贺团队3位同学顺利完成硕士毕业答辩!
- 祝贺!团队工作 Deep-JGAC: End-to-End Deep Joint Geometry and Attribute Compression for Dense Colored Point Clouds 发表于 IEEE Transactions on Circuits and Systems for Video Technology 期刊。
- 祝贺!团队工作 Rate-Reconfigurable Deep Point Cloud Compression with Perceptual Bit Allocation Optimization 发表于 IEEE Transactions on Image Processing 期刊。
- 团队6位同学参加中国图像图形大会 (CCIG 2026) 。
- 智能媒体编码实验室网站正式上线!欢迎在智能视觉编码、点云压缩、机器视觉质量评价、VR/AR 和生成式视觉应用方向开展交流合作,团队长期招收博士、硕士研究生,欢迎优秀本科生参与科研训练。
Paper Insights
论文导读
- 17点云压缩TCSVT|面向V-PCC的属性与几何联合码率分配优化
- 16图像质量TOMM|基于全局—局部渐进融合与语义对齐质量迁移的无参考图像质量评价方法
- 15点云压缩TBC|基于双模态运动估计与时空条件残差编码的深度动态点云属性压缩
- 14点云压缩TCSVT|密集有色点云的端到端几何与属性联合压缩
- 13点云压缩TIP|感知码率分配优化的码率可重构深度点云压缩
- 12点云上采样TIP|基于深度学习的大规模彩色点云联合几何与属性上采样
- 11点云压缩TBC|基于体素 Transformer 和稀疏卷积的 3D 广播点云属性压缩
- 10会议专题2025 年 IEEE 机器学习与媒体计算国际研讨会录用论文导读
- 09点云去噪SPL|基于潜在扩散模型的点云属性去噪方法
- 08光场压缩TBC|LFIC-DRASC:基于解耦表示与非对称卷积的深度光场图像压缩
- 07点云质量TMM|RegR-PCQA:基于规则化表示的彩色点云质量评价
- 06点云质量基于 3D 和 2D 空间互补特征的彩色点云质量评价方法
- 05图像质量基于多粒度嵌入和空间-通道自适应的图像质量评估
- 04特征编码基于多尺度特征重要性的端到端编码与码率分配
- 03感知编码VP-JND:面向图像压缩的视觉感知辅助图像级恰可察觉失真预测模型
- 02机器视觉编码DT-JRD:面向机器视频编码的基于深度 Transformer 的恰可识别失真预测模型
- 01感知编码面向图像与视频压缩的对象级恰可识别失真预测方法研究